第 13 章 推理模型:CoT、投票与 GRPO 强化学习
|
本章导读:实现四类推理模型构建方法——推理时扩展、纯 SFT、 纯强化学习(GRPO)与 SFT+RL 流水线,并以统一评测对比方法与规模的影响。 本章是全书最后一章,任务从「调用外部工具」转向「生成内部思考」。 学完本章你将能够:
产出与代码: |
13.1 推理模型的定义:判定标准与两个层次
模型发布会常说自家模型「会推理了」。判断这句话是否成立,需要一个可操作 的定义。本教程采用的定义是:以多步骤生成、包含中间过程的方式解答问题的模型。 关键在「多步骤 + 中间过程」,不在「难」。 「法国的首都是哪里」是事实检索(❌);「火车 60 英里/小时开 3 小时走了 多远」需要先识别「距离 = 速度 × 时间」,再代入计算(✅)。
这个判据有时效性:几年前火车题还能当正例,今天大多数 LLM 已经能答对它。 现在能区分推理模型的,是更复杂的任务:解谜题、数学推导、数学证明、 复杂编程。判据会随模型能力的普遍提升而失效——这是全书唯一一个会随时间 过期的正例,引用时需要先核对。
「推理」一词实际上用在两个不同的层次上,需要先拆开:
| 层次 | 含义 | 对用户可见? |
|---|---|---|
处理层面 |
模型在内部通过多个中间步骤生成结果 |
不一定 |
呈现层面 |
最终答案中包含某种推理过程 |
可见 |
中间步骤可以显式(思维链直接写在回答里),也可以隐式(内部多轮迭代 但只返回答案,如 o1 的做法)。这个区分的意义在于:「会写思考过程」≠ 「是推理模型」。一个模型输出了「让我想想…」,可能只是模仿格式。 反过来,许多并非为推理设计的 LLM,答案里同样会出现中间步骤。 设想一份 SFT 数据全部带「首先…然后…」,训出来的模型个个都会写 「首先…然后…」——它内部多做了一步计算吗?没有。输出格式可以零成本 伪装,处理过程不能。至于模型是否真的在「思考」,工程事实与哲学断言 要分开:生成了中间步骤、性能提升是事实;「有意识地在推理」是另一个 问题。
什么时候该用推理模型?按任务类型选择,同时考虑它的三个代价:
| 适用(需多步推理) | 不适用(一步到位) | 推理模型的三个弊端 |
|---|---|---|
解谜题 |
总结 |
成本更高——生成更多词元 |
高级数学推导 |
翻译 |
输出更冗长——中间步骤全吐给用户 |
复杂编程问题 |
基于知识的问答 |
过度思考反而出错——最反直觉 |
第三条最反直觉:推理能力不是单调增益。简单问题上强行推理会引入 错误——一步能答对的题,每多绕一步都是新的出错机会。一条实用的 启发式规则:如果一个问题本身不涉及推理,针对它优化推理模型没有必要。 给「法国的首都」做思维链,不会提升正确性,只会制造错误。工程上的 对应做法是任务分类路由:简单查询分流给普通模型,只把复杂推理交给 推理模型。路由层直接决定 LLM 应用的成本结构——推理模型的高价词元, 只应花在需要多步推理的任务上。
四类方法各有位置:

第一类方法不改动任何权重,只改解码方式。三种手段的机制如下:
-
CoT 提示:在 prompt 里给出(或暗示)「请一步一步思考」,让模型把 中间推导写出来。机制上,每个已生成的词元都进入下一步的上下文—— 写出来的中间步骤等于给模型增加了额外的「计算步数」,原本要在一次 forward 里完成的推理,摊到了多个 forward 上。Transformer 是固定深度的 网络,一次 forward 能做的串行计算步数上限就是层数——这是不碰权重就能给模型 「加算力」的唯一手段;
-
多数投票(自一致性,self-consistency):同一问题采样 N 次 (温度 > 0),对最终答案取多数。它依赖一个假设:错误答案彼此分散, 正确答案趋于收敛——所以投票只在「准确率过半」的基座上稳定有效, 13.7 节的实验(SFT-small vote(5) 仅 2%)就是这个假设失效的情形;
-
束搜索(beam search):每步保留概率最高的 b 个前缀并行扩展, 最终取总概率最高的序列。它与采样的取舍在于:采样提供多样性, 束搜索提供确定性的最优——对数学这类有唯一答案的任务合适, 但对开放生成会产出千篇一律的文本,且推理开销是 b 倍。
零训练就有提升,为什么还要后三类方法?因为推理时扩展的上限由基座 决定。投票只能收敛于「模型已经会的东西」——基座答不对的题,采样一万次 也投不出正确答案;束搜索找的是概率最高的序列,不是正确答案。解码层 能放大已有的能力,不能创造新能力。要突破这个上限,就得改权重—— 13.2 起的三节做这件事。
13.2 数据转换:特殊词元装不进 GPT-2 词表
本章的数据分两路:SFT 用 Sky-T1-17k(带思维链的推理数据),RL 与评测用 GSM8K(小学数学应用题,标准答案是整数)。前者教「怎么思考」,后者判 「答没答对」。
第一道障碍出现在数据转换阶段:Sky-T1 的特殊词元(如
<|begin_of_thought|>)在 GPT-2 的 BPE 词表里不存在。GPT-2 的
50257 个词元是第 2 章就定死的,加新词元意味着重训词表、重训嵌入,
等于推倒重来。convert_data.py 的处理是做字符串替换:
# scripts/convert_data.py
s = s.replace("<|begin_of_thought|>", "think")
s = s.replace("<|end_of_thought|>",   "think")     # 开头结尾同词!
s = s.replace("<|start_of_final_answer|>", "<answer>")
s = s.replace("<|end_of_final_answer|>",  "</answer>")
# 缺标签的样本兜底:think{推理}think\n<answer>{答案}</answer>
转换后的标签格式定型为 think 推理过程 think\n<answer>答案</answer>。
「开头结尾都用 think」是一个务实选择:GPT-2 词表装不下自定义特殊词元,
而一个普通词加 <answer> 标签,足以让模型学会「先想后答」的结构。
注意这个妥协不对称:转换把思考段的开头结尾压成了同一个词,答案边界
却保留了成对标签。原因是两边的消费者不同。思考段的边界给模型看,
结构对称与否不影响「先想后答」的学习;答案的边界给程序看,奖励函数
抽取答案、评测脚本判分,全靠 <answer> 这个稳定锚点做解析。
格式妥协可以选,解析锚点不能丢。做工程妥协时,应当选不伤机制的
那一种。
13.3 奖励函数:规则奖励的构成与权重
GRPO 不需要训练奖励模型——数学任务的正确性可以自动判定,用规则奖励
就足够(core/reward.h)。RL 与评测共用同一实现,保证口径一致:
训练时优化的奖励与评测时考核的准确率,必须是同一把尺子,否则就是在
优化一个东西、考核另一个东西。
// 答案抽取优先级:<answer>...</answer> → \boxed{...} → "#### " → "The answer is"
inline std::string extract_answer(const std::string& text);
// 归一化:去空白/逗号/$/%/单位/句号,可比 72 与 "72." 与 "$72"
inline std::string normalize_for_compare(const std::string& raw);

double composite_reward(text, gold, w_fmt, w_acc);  // 默认 w_fmt=w_acc=0.5
//   format_reward:    输出符合 think...think + <answer> 标签结构
//   accuracy_reward:  extract_answer 后与 gold 匹配
w_fmt = w_acc = 0.5 的组合对应「先教会格式,再追求答对」的平滑起步:
格式分保证 RL 早期 reward 信号不全是 0(策略梯度需要非零方差才能更新,
13.4 节解释原因),准确率分把模型往答对的方向拉。复合奖励就是一条
加权求和:
为什么准确率分不能单独承担奖励?因为 RL 早期模型几乎全错:同一道题 采出的回答全错,奖励全组相同、方差为零,参数不会更新。格式分在这个 阶段提供信号——格式有对有错,奖励就有差异。两个分不是简单加权, 是时间上的接力:早期靠格式分维持信号,格式熟练后准确率分接管 主要梯度。
规则奖励还有两个好处:不训练奖励模型,省一份算力;也不像 LLM 评委 那样有评判者混淆风险——本教程的实测中,裁判曾把待评回复当成自己的输出 打分。规则没有这个问题,它只认字符串。
13.4 GRPO:advantage 与策略梯度训练循环(rl_train.h)
DeepSeek-R1-Zero / TinyZero 路线在 core/rl_train.h 的 grpo_step 中
实现:
// 1) 每个 prompt 采 G 条 rollout(no-grad,temperature 0.9 + top_k 50)
for (int64_t g = 0; g < cfg.group_size; ++g) {
    auto r = sample_rollout(model, prompt_ids, cfg.max_new_tokens, ...);
    gen_texts.push_back(prompt + decode(r.gen_tokens));
}
// 2) 组内归一化 advantage——GRPO 的全部创新就在这一行:
advantage = (reward - mean_group) / (std_group + 1e-8);
// 3) 重新 forward 整个序列(带梯度),取生成段的 log-prob
auto lp = compute_completion_log_probs(model, full_seq, r.prompt_len);
// 4) 策略梯度:loss = -mean(advantage × log_prob)
auto term = -lp * adv_t;
第 4 行是整个 RL 的引擎,值得从零推一遍它为什么能学习。先回忆第 5 章 建立的心智模型:优化器只会做一件事——调整参数让 loss 变小。那么 「想让模型学会什么」,就把它写成 loss 的下降方向。
这里的 log_prob 是模型给这条回答打出的对数概率:log_prob 越大,
模型越「倾向」生成这条回答。看这个 loss 在两种情况下的走向:
好回答(advantage > 0):
    loss = -(正数) × log_prob
    → 想让 loss 变小,就要让 log_prob 变大
    → 提高这条好回答的生成概率 ✓

差回答(advantage < 0):
    loss = -(负数) × log_prob = 正数 × log_prob
    → 想让 loss 变小,就要让 log_prob 变小
    → 压低这条差回答的生成概率 ✓
对比第 7 章的监督微调:SFT 的 loss 把「生成结果」往标准答案上拉 (每个词元都有正确标签);这里的 loss 没有任何标签,只有「这条回答 好不好」的分数——训练信号从标签换成了奖励。这就是强化学习与 监督学习的本质分界,也是为什么第 12 章工具调用可以用 SFT (有标准对话可抄),而「学会答对数学题」要更进一步就得靠 RL 或蒸馏(对没见过的 题,没有可抄的标准思考过程,只有对错可判)。
顺带解释 13.3 节埋下的伏笔——「策略梯度需要非零方差才能更新」: 如果一组 G 条回答的奖励全部相同(全对或全错),减去组均值后 advantage 全为 0,loss 恒为 0,没有任何梯度信号,参数原地踏步。 这就是奖励函数要「格式分 + 准确率分」混合的原因——RL 早期模型 几乎全错,准确率分全组相同,但格式分仍有差异,信号不中断; 等格式熟练后,准确率分再接管主要梯度。
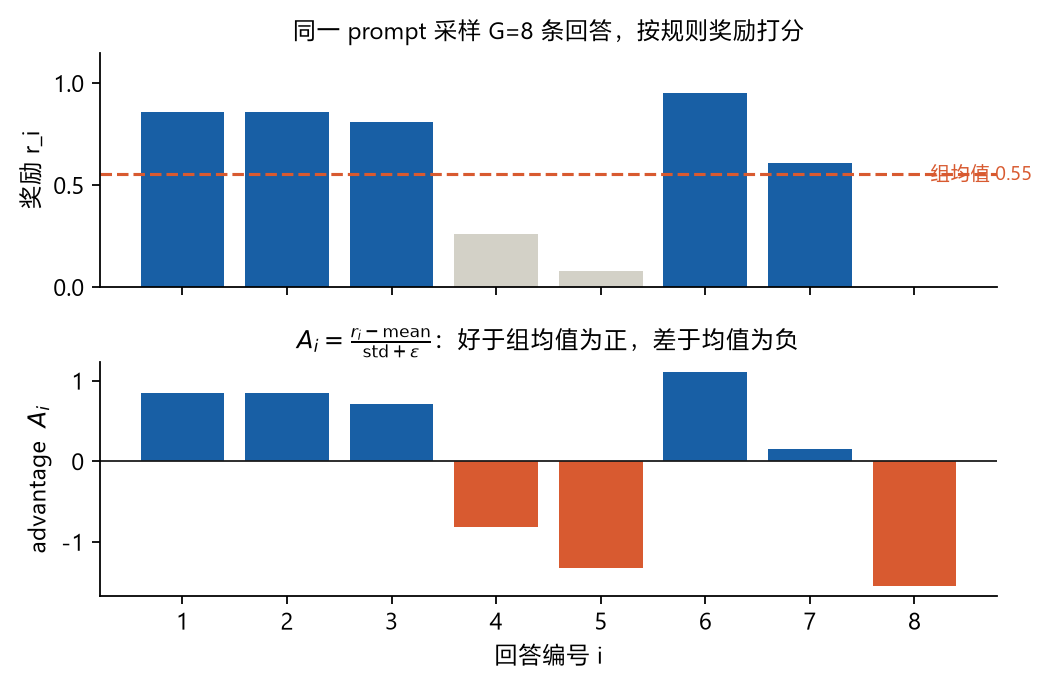
第 2 步和第 4 步合起来就是 GRPO 的全部数学。组内归一化 advantage (G 条同题回答互为基线):
策略梯度损失——advantage 为正就抬高那条回答的对数概率,为负就压低:
为什么用「组内相对比较」而不是 value network(PPO 的做法)?同一个 prompt 采 G 条回答,好于组均值的 advantage 为正、差于均值为负—— 不需要额外训练一个打分网络,显存与实现复杂度同时减半。对 124M/355M 这样的小规模模型,这是让 RL 跑起来的最小配置。
这个归一化公式还有两层设计意图:减组均值等于用「同一道题的其他 回答」当基线——题目本身的难度差异(简单题全对、难题全错)在整组减法中 消掉,advantage 只衡量「这条回答比同题的其他回答好多少」;除组标准差则把 不同题目奖励的幅度拉到同一尺度,学习率不需要随奖励的绝对大小调整。 一行减法除法,同时解决了基线选择与尺度对齐两个经典 RL 问题。
一个 G=8 的采样组从奖励到 advantage 的完整过程:
13.5 监督微调:105 秒学会格式
train/sft_train 与第 7 章同源(-100 掩码 + Alpaca 模板 + 全参微调),
数据换成 think/answer 标签格式。实测训练成本(RTX 4090 级,1 epoch):
small  (124M): 1550 步, 1.6M tokens, 105 秒, val_loss 1.221
medium (355M): 3150 步, 1.4M tokens, 335 秒, val_loss 1.100   # batch 减半
SFT 后格式合规率已达 96–100%——「think → think → <answer>」的骨架 学得很稳。一个自然的问题是:SFT 成本这样低(105 秒),能否只用 SFT? SFT 教的是「抄标准思考过程的格式」,不是「自己想对」;它的定位是为 RL 铺路,让后续 RL 只需专注「把答案想对」。13.7 节的实验给出结论: 格式全会、答案全错,就是纯 SFT 的上限。
13.6 DeepSeek-R1 案例研究:四个关键概念
本项目的 RL/SFT+RL 路线直接复刻 DeepSeek-R1 的方法论。四个关键概念 每个都对应一种流行的误读:
-
R1-Zero 的「纯 RL」跳过的是 SFT 与奖励模型,不是预训练。标准 RLHF 流程是 SFT → 奖励模型 → RL;R1-Zero 直接在完整预训练过的 DeepSeek-V3 上做 RL,所以叫「纯 RL」。它没有跳过预训练:6710 亿参数的底子是预训练 给的,RL 只负责在其上训练推理能力;
-
两种奖励机制:准确性奖励(代码用编译器验证、数学用确定性系统 评估,客观可自动判定)与格式奖励(确保输出遵循
<think>标签格式)。 注意格式奖励「依赖一个大语言模型来判定」——这与第 7 章的 LLM-as-judge 是完全相同的手法,也因此继承了同样的问题: 本教程实测中,裁判曾把待评回复当成自己的输出("I’d rate my own response as 95"),R1-Zero 的格式奖励同样面临评判者混淆风险; -
「Aha 时刻」:研究人员发现模型在 RL 过程中自发生成了带推理过程的 回答——尽管没有任何显式训练教它这么做。这与第 1 章的「涌现」是 同一现象:只优化答案正确性,却学会了思考。R1-Zero 的价值是 证明路径可行,不是性能最优——R1 本身后来还是走了完整的多阶段 流水线;
-
R1-Distill 的「蒸馏」不是传统知识蒸馏:教师不给 logits 软标签, 而是生成监督微调数据集让学生做指令微调(标准交叉熵)—— 工程上与第 7 章的流程完全一样,只是数据换成了强推理模型生成的样本, 更准确的叫法是「数据蒸馏」。
第 3 条末尾的「多阶段流水线」,入口是冷启动(cold start)。R1-Zero 的 纯 RL 有两个肉眼可见的毛病:语言中英混杂、输出可读性差。R1 的补救发生在 RL 之前——人工筛选数千条带完整思维链的问答样本,对 DeepSeek-V3-Base 做一轮 SFT,给 RL 一个「会好好写字」的起点。之后依次是:面向推理的 RL → 拒绝采样生成约 80 万条 SFT 数据再训一轮 → 覆盖全部场景的最终 RL。 对照本章实现,这条流水线的分工一目了然:13.5 节的 SFT 是微型冷启动, 先把 think/answer 格式教会;13.4 节的 GRPO 才能专心优化「答案对不对」。
还有一条对小规模实践最重要的实验结论:DeepSeek 把 R1-Zero 的纯 RL 直接应用到 Qwen-32B 上,结论是「对于较小的模型,蒸馏远比纯强化学习 有效」。R1-Zero 是 6710 亿参数,Qwen-32B 是 320 亿,相差 21 倍; 纯 RL 的涌现可能需要足够大的模型容量作为前提,小模型上高质量推理 数据的 SFT 是更有效的策略。这解释了本项目 355M 模型上 GRPO 「跑通了但收益有限」的结果。方法论上还有一条可复用的做法:对比实验里 应补上「SFT+RL 对照组」——要证明某个组件的贡献,必须做「去掉它」的 消融实验,与第 8 章的消融思想一致。
13.7 对比实验:规模、投票与 RL 的实测结果
GSM8K test 50 题的实测结果(docs/compare-report.md):
| 模型 × 策略 | 准确率 | 格式合规 | 平均耗时 | 结论 |
|---|---|---|---|---|
SFT-small greedy |
0% |
96% |
0.54 s |
格式对、答案错 |
SFT-small vote(5) |
2% |
98% |
2.6 s |
投票略有提升 |
SFT-medium greedy |
10% |
96% |
1.2 s |
规模才是下限 |
SFT-medium vote(5) |
4% |
100% |
5.6 s |
反而更差 |
RL-medium greedy |
8% |
98% |
1.0 s |
待调参 |
RL-medium vote(5) |
0% |
100% |
4.8 s |
退化 |
这张表有三个反直觉的观察:
-
推理时扩展不是万能药:vote 在 medium 上 4% < greedy 的 10%—— 「多数样本都答错时,投票只会把错误答案选得更稳」。自一致性方法的经典结论 「majority@N 只在高准确率基座上稳定提升」在 50 题小样本上得到了 直接验证。另外注意:50 题的 1 题之差就是 2%,小样本的方差足以 淹没方法差异——读实验数字,先看样本量;
-
规模决定下限:medium 10% vs small 0%——同样的数据、同样的训练, 124M 装不下小学算术,355M 勉强入门;
-
RL 跑通了,但收益还没出来:100 步 GRPO(batch=1, group=2, lr=1e-6) 208 秒,reward 稳定在 0.5(格式分拿满、准确率分没有起色)。 报告给出的调参建议:lr → 1e-5、group → 4–8、步数 → 500+、加 KL 惩罚 防策略漂移——这组参数对应习题 1 的实验。
如何理解「投票反而更差」:多花 4 倍时间,准确率还降了 6 个百分点。 回到 13.1 节埋的假设:投票依赖「正确答案趋于收敛」,而 medium 的 greedy 基座准确率只有 10%,五次采样里错误答案分散在多种错误上, 多数票选中的未必是正确的那个。这不推翻自一致性方法本身,只说明 它的前提在低准确率基座上不成立——方法没有错,是使用条件不满足。
13.8 编译运行与预期输出
本章完整流程如下(数据下载 → 编译 → 数据转换 → SFT → RL → 推理 → 评测):
cd chapters/chapter13_reasoning
./scripts/download-data.sh            # Sky-T1-17k + GSM8K parquet → data/downloads/,转换出 data/*.json
./scripts/build.sh
# 数据转换已由下载脚本自动完成:Sky-T1-17k → data/sft-train.json(13.2 的标签替换)、
# GSM8K → data/rl-train.json 与 data/eval-test.json
# SFT(small 示例;medium 换 --size medium + batch 2)
./scripts/run.sh sft_train --data data/sft-train.json \
    --size small --epochs 1 --batch 4 --max-length 768 --lr 5e-5 \
    --out data/reasoning_small_sft_gsm.pt
# RL(从 SFT 初始化,DeepSeek-R1 蓝图;去掉 --init 即纯 RL)
./scripts/run.sh rl_train --data data/rl-train.json \
    --size medium --init data/reasoning_medium_sft_gsm.pt \
    --max_steps 100 --batch 1 --group 2 --lr 1e-6 \
    --w_acc 0.5 --w_fmt 0.5 --out data/reasoning_medium_rl_gsm.pt
# 推理:CoT + 多数投票
./scripts/run.sh reasoning_chat --model data/reasoning_small_sft_gsm.pt --size small \
    --strategy vote --samples 5
# 统一评测 + 报告
./scripts/run-compare.sh              # 产出 docs/compare-report.md
RL 训练日志每步一行:
[best sample @ step 95] ... ### Response: think Holly takes 3 x 2 = 6 ...
[rl_train] step=96 mean_reward=0.5 loss=0
[rl_train] step=99 mean_reward=0.5 loss=0     ← reward 平了?去读 reward 分解
日志中的 loss=0 不是异常,而是 13.4 节解释过的现象:组内方差为零 →
advantage 全零 → 无梯度。遇到它,先读 reward 分解定位原因,而不是重跑。
排错时可以先对照公式:日志里的每个反常数字,都应能在 13.4 节的公式中
找到对应的位置。
本章小结
-
推理模型的判定标准是「多步骤生成并包含中间过程」;处理层面与呈现层面是两回事,「会写思考过程」不等于「是推理模型」。
-
四类构建方法:推理时扩展(零训练,上限由基座决定)、纯 SFT、纯强化学习(GRPO)、SFT + RL 流水线;简单任务上强行推理反而出错,应做任务分类路由。
-
GRPO 以组内相对优势替代价值网络,一行减法除法同时解决基线选择与尺度对齐;奖励全组相同则 advantage 全零、无梯度,格式分是早期的信号来源。
-
实验结论:模型规模决定推理能力下限;多数投票只在高准确率基座上有效;小模型上蒸馏优于纯强化学习;loss=0 要去读 reward 分解。
自测清单
能不回看就答出这些,本章就算过关:
-
数据转换后标签为
think…think\n<answer>…</answer>,无残留特殊词元 -
SFT 后格式合规率 ≥ 95%(骨架学会)
-
medium 的 greedy 准确率显著高于 small(规模效应直接确认)
-
GRPO 全链路跑通:rollout → 奖励 → advantage → 策略梯度 → checkpoint
-
能解释 vote 何时有益何时有害(基座准确率 + 样本量)
-
能复述 \(\mathrm{loss} = -A \cdot \log \mathrm{prob}\) 在 advantage 正负两种情况下各自的优化方向
-
eval_math对 base/sft/rl 各 checkpoint 统一口径评测
习题
-
按报告给出的参数调 RL:
lr=1e-5, group=8, max_steps=500,画出 reward 曲线与 greedy 准确率,看 RL 在本项目的规模上能带来多少提升。 -
把
w_fmt从 0.5 降到 0.1,观察格式合规率与准确率的变化。 -
给
eval_math增加 majority@32 与束搜索策略,对比「多采样」与 「精细搜索」在同预算下的表现。 -
用第 12 章的方式给推理模型套一层 dispatcher:
<answer>出现才停。 -
给 13.7 节的对比实验补上「SFT + RL」与「RL(无 SFT 初始化)」两个 对照组——消融 SFT 环节,观察格式信号需要多少步才能自行出现。
-
(思考)格式奖励与准确率奖励都是「结果奖励」。如果想奖励 思考过程的质量(步骤正确性),规则还能写出来吗? 这正是过程奖励模型(PRM)要解决的问题。
拓展阅读
-
DeepSeek-AI, 2025, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(GRPO 与「蒸馏胜过小模型纯 RL」结论的出处): https://arxiv.org/abs/2501.12948
-
Shao et al., 2024, DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(GRPO 算法的原始出处): https://arxiv.org/abs/2402.03300
-
Cobbe et al., 2021, Training Verifiers to Solve Math Word Problems(GSM8K 数据集): https://arxiv.org/abs/2110.14168
-
Wei et al., 2022, Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(CoT 提示原始论文): https://arxiv.org/abs/2201.11903
-
Wang et al., 2022, Self-Consistency Improves Chain of Thought Reasoning in Language Models(多数投票/自一致性原始论文): https://arxiv.org/abs/2203.11171
-
NovaSky-AI, Sky-T1 官方仓库与 Sky-T1-17k 数据集: https://github.com/NovaSky-AI/SkyThought | https://huggingface.co/datasets/NovaSky-AI/Sky-T1_data_17k
-
全书至此结束。从
torch::tensor到 GRPO,chapter10_serving / chapter11_nl2bash / chapter12_toolcalling 三个独立工程与这套推理流水线共享同一份 core 代码。 回到导览