第 4 章 组装 GPT-2
|
本章导读:将第 3 章的多头注意力装配进 Transformer 块,堆叠 12 层得到 完整的 GPT-2 架构,并核算其参数构成——零件已在第 2、3 章备齐,本章负责总装。 学完本章你将能够:
产出与代码: |
4.1 为什么从 GPT-2 学起:七个超参
组装 LLM 要回答的第一个问题不是「怎么写代码」,而是「参照哪个模型」。 候选是 GPT-2 与 GPT-3:前者最大 15 亿参数,后者 1750 亿。按规模直觉似乎 应该选后者,但学习实现的判断依据不是规模,而是三个条件:架构是否一致、 权重是否可得、硬件是否负担得起。逐项对比:
| 维度 | GPT-2 | GPT-3 |
|---|---|---|
架构 |
基准架构 |
与 GPT-2 基本相同 |
参数量 |
最大 15 亿 |
1750 亿 |
权重公开 |
✅ 已公开(第 5 章要加载) |
❌ 截至本教程撰写时未公开 |
运行条件 |
单台笔记本即可 |
需 GPU 集群(单张 V100 训练需 355 年) |
三个条件中,GPT-3 只占第一个:其架构与 GPT-2 基本相同,最大的差别只是 规模。在小模型上学会的实现,可以原样迁移到大模型;而「权重公开」与 「单机可跑」两条,只有 GPT-2 满足。因此本教程从 GPT-2 学起。
一个考据细节:GPT-2 论文标注的参数量是 1.17 亿,后来被修正为 1.24 亿。 本教程采用修正值,4.7 节的参数核算会回到这个数字。
参数(parameter)是模型中可训练的权重,训练中通过调整它们来最小化
损失函数——一个 2048×2048 的权重矩阵就是 419 万个参数。本章的任务是
把这样的参数组织成一个 1.24 亿级的架构。定义它只需要七个超参:除 n_layers 是本章引入的新成员外,其余六个都
来自第 2、3 章:
struct GPTConfig {
    int64_t vocab_size = 50257;       // BPE 词表(第 2 章)
    int64_t context_length = 1024;    // 最大可观察的词元数
    int64_t emb_dim = 768;            // 每个词元的嵌入向量维度
    int64_t n_heads = 12;             // 注意力头数(第 3 章)
    int64_t n_layers = 12;            // Transformer 块数
    double drop_rate = 0.1;           // dropout 比例
    bool qkv_bias = false;            // Q/K/V 投影是否加偏置(GPT-2 官方为 true,本教程取 false)
};|
跨章约定: |
实现策略是「先搭骨架,再换真件」:先写一个 DummyGPTModel,层归一化
与 Transformer 块都用空壳占位,但完整数据流(六步 forward:词元嵌入
位置嵌入 → 相加 → dropout → N 个块 → 最终归一化 → 输出头)先跑通,
输入输出形状锁定为 [2, 4, 50257]。真实版只把三个占位换成真件,forward
代码一行不改。本教程的 C++ 版直接从真件讲起,但「先锁形状、再填内容」的
做法值得记住:骨架始终可运行,零件换错时能立刻定位到刚改的那一处。
本章的组装流水线——先造零件,再总装:

4.2 层归一化(LayerNorm)
深层网络训练有两大障碍:梯度消失与梯度爆炸,表现为训练不稳定、loss 曲线 迟迟不降。层归一化(LayerNorm)的对策是把每层的激活值强行调整成 均值 0、方差 1,以稳定各层输入的分布。GPT-2 及现代 Transformer 把它用在 多头注意力和 FFN 之前,以及最终输出层之前。
计算分两步。先沿特征维 d 算每个样本自身的均值和方差:
再标准化,并用两个可训练参数做仿射还原(γ 对应代码里的 scale,
β 对应 shift,ε 防止除零):
class LayerNormImpl : public torch::nn::Module {
public:
    explicit LayerNormImpl(int64_t emb_dim) {
        scale_ = register_parameter("scale", torch::ones(emb_dim));
        shift_ = register_parameter("shift", torch::zeros(emb_dim));
    }
    torch::Tensor forward(torch::Tensor x) {
        auto mean = x.mean(-1, /*keepdim=*/true);
        auto var  = x.var({-1}, /*unbiased=*/false, /*keepdim=*/true);  // 有偏方差!
        auto norm_x = (x - mean) / torch::sqrt(var + eps_);             // eps_ = 1e-5
        return scale_ * norm_x + shift_;
    }
    torch::Tensor scale_, shift_;
    double eps_ = 1e-5;
};
这里有一个看似矛盾的设计:数据刚被归一化成均值 0 方差 1,代码里又乘上
scale、加上 shift 两个可训练参数——归一化不就被破坏了吗?恰恰
相反。归一化在稳定分布的同时,也抹掉了层原本学到的表示尺度。这两个
参数的初值是 1 和 0,此时输出与输入完全相同;训练中模型可以自行学习
各维度合适的缩放与偏移,需要就用,不需要就保持初值。
四个实现细节需要逐一交代:
-
scale/shift 为什么可训练:如上——归一化抹掉了层学到的表示尺度, 这两个可训练参数(初值 1 和 0)让模型有能力恢复它;
-
有偏方差(
unbiased=false,分母用 n 而非 n−1):三条理由—— ① 嵌入维度很大(768),n 与 n−1 的差别可忽略;② 与 GPT-2 的归一化层 兼容;③ 原始 GPT-2 用 TensorFlow 实现,这是 TF 的默认行为。第三条属于 历史原因,但第 5 章要正确加载 OpenAI 预训练权重,必须与上游一致—— 在工程上,与上游一致常常比数学上的优雅更重要; -
dim=-1+keepdim=true是固定搭配:三维张量[batch, tokens, emb]的特征维编号是 2,写-1统一表示「最后一维」,代码不必在 2D/3D 输入 之间切换;keepdim保留长度为 1 的维度,结果才能与原张量广播相减; -
eps(1e−5):加在方差上防止除零。
|
LayerNorm vs BatchNorm:前者沿特征维度归一化(每个样本独立), 后者沿批次维度归一化(依赖批次统计量)。LLM 的 batch size 常受硬件与 用例限制,推理时甚至 batch=1;LayerNorm 不受批次大小影响,在分布式 训练与资源受限部署下更灵活稳定。LLM 一律采用 LayerNorm,原因就在这里。 |
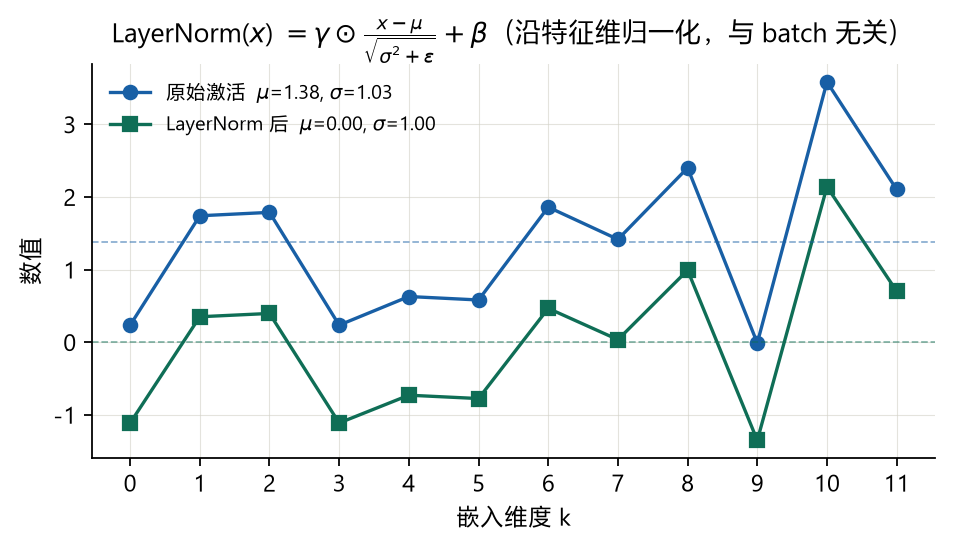
实测:随机正态输入经 LayerNorm 后每行 mean ≈ 0、var ≈ 1。下图展示上式 的实际效果——原始激活带均值与方差偏移,归一化后两者都被消除:
4.3 GELU 与 FeedForward
GELU:负输入不全置零
LLM 的激活函数有一条演进线:ReLU(传统标配,负输入置 0,0 点有尖锐 拐角)→ GELU(GPT-2 所用,结合高斯分布,平滑)→ SwiGLU(现代 LLM 常用,sigmoid 门控线性单元)。演进方向一致:曲线越平滑,优化越好做。
ReLU 有一个已知缺陷:对负输入输出恒为 0,接收负输入的神经元不再参与 学习——这就是 dying ReLU。GELU(Gaussian Error Linear Unit,2016 年由 Hendrycks 与 Gimpel 提出)的处理更温和:对负输入输出小的非零值—— 这些神经元仍参与学习,只是贡献较小。
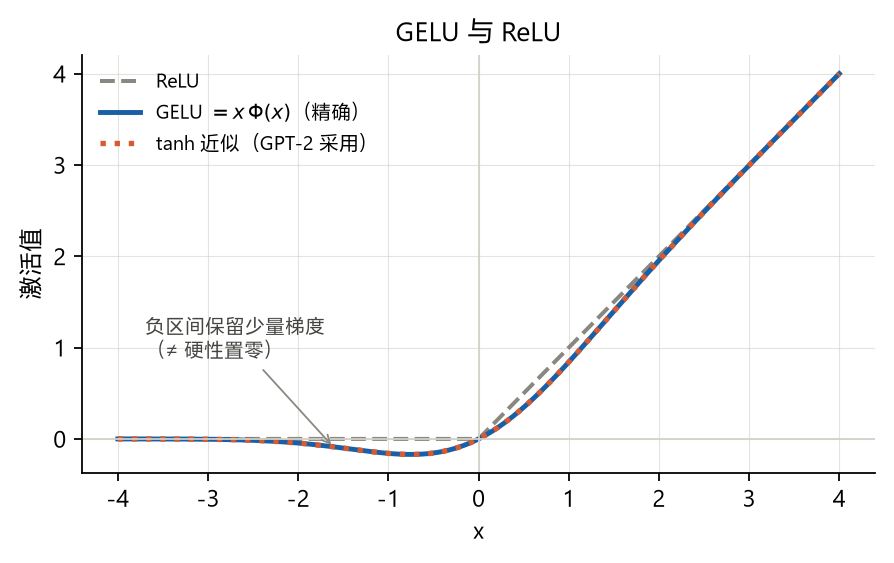
GELU 的精确定义是 \(\mathrm{GELU}(x) = x \cdot \Phi(x)\),Φ 为标准高斯分布的累积分布函数。 直观理解:按输入的数值大小加权,而不是像 ReLU 那样按符号一刀切。 精确式与实际使用的 tanh 拟合近似如下——原始 GPT-2 就是用这个近似训练的:
torch::Tensor forward(torch::Tensor x) {
    auto c = torch::sqrt(torch::tensor(2.0 / 3.14159265358979323846));
    return 0.5 * x * (1.0 + torch::tanh(c * (x + 0.044715 * torch::pow(x, 3))));
}
0.044715 不是物理常数,是拟合得到的经验系数。两条曲线几乎重合,但都与
ReLU 有本质区别:负区间不再硬性置零。
数值对照:GELU(1.5) ≈ 1.3996,而 ReLU(1.5) = 1.5——GELU 在正区间略微
压低大值。与 ReLU 相比,GELU 的优势有两点:
-
平滑带来更好的优化:ReLU 在 0 点的尖锐拐角让优化变难,深度网络中 尤其明显;GELU 全程平滑,允许参数做更细微的调整;
-
负输入的神经元不死:ReLU 对负输入输出恒 0,神经元停止参与学习; GELU 输出小的非零值,这部分神经元仍能贡献梯度。
FeedForward:先扩 4 倍,再缩回
FeedForward(FFN)是逐位置的两层 MLP(Expand → GELU → Contract),是 Transformer 块中参数量最大的子模块,结构却只有两层:第一层把 768 维扩到 3072 维(正好 4 倍),过一层 GELU,第二层再缩回 768:
explicit FeedForwardImpl(const GPTConfig& cfg) {
    layers = register_module("layers", torch::nn::Sequential());
    layers->push_back(torch::nn::Linear(cfg.emb_dim, 4 * cfg.emb_dim));  // 768 → 3072
    layers->push_back(GELU());
    layers->push_back(torch::nn::Linear(4 * cfg.emb_dim, cfg.emb_dim));  // 3072 → 768
}
「先扩 4 倍再缩回」的反瓶颈结构乍看是浪费,实际有两点理由:① 先扩展到 高维空间做非线性变换,再压缩回来——高维空间给了非线性变换更大的余地, 模型能表达更复杂的函数;② 输入输出维度一致,堆叠多层时不需要调整 维度。「维度不变」是本章反复出现的主题:FFN 保持 768、TransformerBlock 保持 768、整个 Transformer 栈保持 768,只有最后的输出头把 768 映射到 50257。形状不变,层才能任意堆叠——GPT-2 从 1.24 亿到 15 亿,结构代码不改 一行。写成公式(\(W_1\) 即「Expand」,\(W_2\) 即「Contract」):
|
这里藏着一个 C++ 翻译陷阱:不能写成
|
4.4 快捷连接:对抗梯度消失
梯度消失指反向传播时梯度逐层变小,导致早期(浅层)网络难以有效 训练:网络加深本应带来更强的表达能力,浅层训不动,这份收益就拿不到。
快捷连接(skip connection,又称残差连接,源自视觉领域的 ResNet)的 机制是:跳过一个或多个层,把一层的输出直接加到后续层的输出上——为 梯度提供一条更短的替代路径,反向传播时不必逐层衰减。
main.cpp 的 demo_shortcut 用同一个 5 层 MLP 做了对照实验,梯度绝对值
均值对比(节选)如下:
层           无快捷连接      有快捷连接     提升倍数
layers.0     0.0002017      0.2217        ≈ 1099×
layers.1     0.0001201      0.2069        ≈ 1723×
layers.2     0.0007152      0.3290        ≈ 460×
layers.4     0.0050496      1.3259        ≈ 263×
浅层梯度相差 1099 倍:无快捷连接时,浅层梯度掉到 1e-4 量级,这正是梯度 消失;有快捷连接时,各层梯度稳定在 0.2–1.3,深浅层几乎一致。快捷连接 成为超大规模模型核心构建块的依据不是理论偏好,而是实测到的数量级 差距。
实现上有一个细节:残差相加要求两端形状一致,x.shape == layer_output.shape
不满足时(如演示用的最后一层故意降维 3→1)自动跳过快捷连接。
Transformer 块的两个子块各配一条,见 4.5 节。
4.5 TransformerBlock:两个子模块的分工
前几节备齐了零件:LayerNorm、GELU、FFN、残差连接,加上第 3 章的多头 注意力。现在把它们装进一个盒子——Transformer 块,GPT-2 的标准构件。 理解它的钥匙是两个子模块的分工:
-
多头注意力做跨位置的信息混合:识别输入序列中元素之间的关系,让第 3 个 词的表示里包含第 1 个词的信息;
-
前馈网络做逐位置的特征变换:在每个位置上独立地对表示做深加工。
两者缺一不可:只有注意力没有 FFN,词与词完成了交流,但每个位置的表达 深度不足;只有 FFN 没有注意力,每个位置的表达足够深,但位置之间不交换 信息。
Pre-LN 版的块只讲两句话——归一化前置、残差相加收尾,注意力子块与前馈 子块各来一遍:
对着公式读两遍,有两个最容易看错的地方:LN 在分支内部、残差加在 分支输出上——归一化作用于主干信号,被变换的是副本,加回去的也是 变换后的副本。与下面代码逐行对应:
torch::Tensor forward(torch::Tensor x) {
    // 注意力子块:Pre-LayerNorm + 快捷连接
    auto shortcut = x;
    x = norm1->forward(x);
    x = att->forward(x);            // 第 3 章的 MultiHeadAttention
    x = drop_shortcut->forward(x);
    x = x + shortcut;               // 残差

    // 前馈子块:同样一套
    shortcut = x;
    x = norm2->forward(x);
    x = ff->forward(x);
    x = drop_shortcut->forward(x);
    x = x + shortcut;
    return x;
}
实测:输入 [2, 4, 768] → 输出 [2, 4, 768]。形状不变是 Transformer 块的
契约,也是「块可以无限堆叠」的前提:12 块摞起来是 GPT-2 small,48 块摞
起来是 GPT-2 xl,结构代码一个字不用改。物理维度不变,但内容被重新
编码:每个输出向量都整合了整个输入序列的上下文(即第 3 章的上下文
向量),且输出向量与输入向量一一对应——这使块能直接用于各种序列到序列
任务。
|
Pre-LayerNorm vs Post-LayerNorm:归一化放在子层之前(GPT-2 与现代 Transformer,✅ 训练效果更好——主干信号不经子层变换)还是之后(最初的 Transformer,❌ 通常导致较差的训练效果)——本教程用 Pre-LN。块内完整 顺序要读准:Norm → 子层 → Dropout → 加残差——dropout 作用在分支 输出上,残差加在最后(不是 dropout 加在残差结果上)。这两者差一层 括号,语义完全不同。 |
4.6 总装:GPTModel 与生成循环
零件齐了,开始总装。GPTModel 的 forward 数据流固定六步:词元嵌入
位置嵌入 → 相加 → dropout → 12 个 Transformer 块 → 最终归一化 →
输出头。前五步都已出现,最后一步是新的——输出头,把隐藏表示映射到
词表上:
torch::Tensor forward_hidden(torch::Tensor in_idx) {   // [batch, seq_len] 词元 ID
    auto tok_embeds = tok_emb->forward(in_idx);        // (b, T, 768)  词元嵌入
    auto pos_embeds = pos_emb->forward(torch::arange(seq_len));  // (T, 768) 位置嵌入
    auto x = tok_embeds + pos_embeds;                  // 广播相加(第 2 章 2.7)
    x = drop_emb->forward(x);
    x = trf_blocks->forward(x);                        // 12 个 TransformerBlock
    x = final_norm->forward(x);
    return x;                                          // (b, T, 768) 隐藏表示
}
torch::Tensor forward(torch::Tensor in_idx) {
    return out_head->forward(forward_hidden(in_idx));  // (b, T, 50257) logits
}
输出头把 768 维隐藏表示映射到词表 V=50257,softmax 之后就是下一个词元的 概率分布——语言模型「预测下一个词」的全部数学就这一条:
|
|
最后是生成循环 generate_text_simple——贪心解码,每轮固定四步:
截断上下文 → 无梯度前向 → 取最后位置 argmax → 拼回序列:
for (int64_t i = 0; i < max_new_tokens; ++i) {
    auto idx_cond = idx.index({Slice(), Slice(-context_size, None)});  // 截断上下文
    torch::Tensor logits;
    { torch::NoGradGuard no_grad;
      logits = model->forward(idx_cond); }
    logits  = logits.index({Slice(), -1, Slice()});      // 只取最后一个位置的 logits
    auto idx_next = torch::argmax(torch::softmax(logits, -1), -1, /*keepdim=*/true);
    idx = torch::cat({idx, idx_next}, 1);                // 拼回序列,进入下一轮
}
循环里有两处防御性设计,外加一步推理前置操作,都为同一件事服务:让循环 能无限跑下去。
-
上下文截断:
idx_cond在上下文超过 1024 时只取最后 1024 个词元—— 不截断会因位置嵌入越界而崩溃; -
NoGradGuard:推理不需要梯度,省显存省计算;
-
eval 模式:生成前调用
model→eval(),禁用 dropout 等仅训练期使用 的随机组件,保证推理结果确定。
|
这个 softmax 其实是冗余的——softmax 保持各分数的大小顺序, 所以对 softmax 后的概率取 argmax 与直接对 logits 取 argmax 结果完全相同。 这里保留它只是为了展示「logits → 概率」的完整过程。但注意:第 5 章引入 温度/Top-k 采样后,这步就不能省了——采样需要的是概率分布而非分数。 |
第 5 章会把它升级为温度 + Top-k 采样;现在先用 argmax 最简版。
4.7 参数核算:163M 与 124M
总装的最后一件事是核对参数量。这里会先出现两个看似矛盾的数字:同一个
模型,一次打印 1.63 亿,另一次打印 1.24 亿。main.cpp 的 demo_gpt_model
输出完整账目,全部数字可用第 0 章 §F 的 named_parameters 遍历逐项核对:
| 模块 | 参数量 | 说明 |
|---|---|---|
tok_emb(词元嵌入) |
50257 × 768 = 38,597,376 |
最大单项 |
pos_emb(位置嵌入) |
1024 × 768 = 786,432 |
|
12 × TransformerBlock |
12 × 7,085,568 = 85,026,816 |
见下表 |
final_norm |
2 × 768 = 1,536 |
|
out_head(输出头) |
768 × 50257 = 38,597,376 |
无偏置 |
单个 TransformerBlock(7,085,568):
| 子模块 | 参数量 |
|---|---|
MHA:Q/K/V(无偏置)+ out_proj(含偏置) |
3×589,824 + 590,592 = 2,360,064 |
FFN:768→3072 + 3072→768(各含偏置) |
2,362,368 + 2,360,064 = 4,722,432 |
LayerNorm ×2 |
2 × 1,536 = 3,072 |
实测输出:
Total number of parameters: 163,009,536            ← 全部参数(含输出头)
Number of trainable parameters considering weight tying: 124,412,160
Total size of the model: 621.83 MB                 ← 163,009,536 × 4 字节

[练习 4.1] FeedForward 参数量 = 4,722,432, MultiHeadAttention 参数量 = 2,360,064
[练习 4.2] 公式估算 vs 实际(124M): 163009536 (实际 163009536)
  GPT-2 medium (emb=1024, layers=24, heads=16): 总参数 ...,weight tying 后 ...
  GPT-2 large (emb=1280, layers=36, heads=20):  ...
  GPT-2 xl (emb=1600, layers=48, heads=25):    ...
三个数字的口径各不相同:
-
163,009,536:模型实际参数量——输出头(38,597,376)占了近四分之一;
-
124,412,160:考虑 weight tying(输出头与词元嵌入共享同一份权重 ——
(b, T, 768)的隐藏状态乘以tok_emb.weight.T就是 logits)后的 独立参数量,这正是 GPT-2 small 名字里「124M」的来历; -
621.83 MB:按 float32 存全部 163M 参数的显存/磁盘占用。
一份权重两处使用,参数账立刻少四分之一——论文里的数字与「实例化数一遍」 的数字对不上,原因就在这里。
|
为什么共享一份矩阵是合理的? |
[练习 4.1] 还给出一个重要结论:FFN 参数量(4.72M)几乎是注意力(2.36M) 的两倍——Transformer 的容量大头在前馈网络,不在注意力。这与 「Attention is all you need」留下的第一印象相反。[练习 4.2] 的公式估算与 实测逐位一致;medium/large/xl 三档的参数量也由同一公式打印 (355M / 774M / 1.56B)。
4.8 首次生成:乱码是预期行为
编译并运行本章程序:
./scripts/run.sh chapter04_gpt运行后应看到:「Hello, I am」经 BPE 编码成 [15496, 11, 314, 716],贪心
解码 6 个新词元:
encoded_tensor.shape: [1, 4]
Output length: 10
Decoded text: "Hello, I am <乱码词元>" ← 未训练模型的预期行为输出是乱码,而且这是预期行为——随机初始化的模型只会产生形状正确、 语义无意义的词元,它还没有学过任何语言。
这段乱码同时验证了三件事:形状链全部打通、贪心解码循环工作正常、权重 能在 GPU 上前后向流动。架构正确不等于能生成语言——把乱码变成连贯文本, 是第 5 章预训练的任务。
本章小结
-
七个超参唯一确定一个 GPT 架构。学实现选 GPT-2 的三个理由:与 GPT-3 同架构、权重公开、笔记本能跑。实现采用「先占位骨架、后换真件」的方法, forward 数据流保持不变。
-
三个关键组件:LayerNorm(有偏方差与 GPT-2 兼容;scale/shift 提供 可学习的仿射还原)、GELU(平滑激活,负输入不全置零)、快捷连接(缓解 梯度消失,实测提升两个数量级以上)。
-
TransformerBlock = 注意力(跨位置信息混合)+ FFN(逐位置特征变换), 各配 Pre-LayerNorm 与残差连接,形状守恒。
-
参数三数字互证:163,009,536(全部)、124,412,160(权重共享口径)、 621.83 MB(float32 存储);FFN 容量约为注意力的两倍。
-
未训练模型输出无意义内容是预期行为:架构正确不等于能够生成文本。
自测清单
能不回看就答出这些,本章就算过关:
-
能说出选 GPT-2 不选 GPT-3 的三个理由;
qkv_bias有什么跨章约定 -
DummyGPTModel 输出
[2, 4, 50257];TransformerBlock 输出[2, 4, 768] -
GELU(1.5) ≈ 1.3996,与 ReLU 的 1.5 形成对照 -
参数三数字:163,009,536 / 124,412,160 / 621.83 MB
-
能不看表复述 FFN(4.72M) ≈ 2×MHA(2.36M) 的结论
-
贪心解码 4 + 6 = 10 个词元,输出乱码是预期行为
-
能说出 FeedForward 单表达式构造为什么在 C++ 里是坑
-
能说出 unbiased=false 与 Pre-LN 的理由;scale/shift 为什么可训练
-
能写出块内顺序 Norm → 子层 → Dropout → 加残差,并说清 dropout 与残差谁在外
习题
-
把
GPTConfig改成emb_dim=1024, n_layers=24, n_heads=16(medium 规模),先跑 [练习 4.2] 公式估出参数量,再实际实例化验证 (显存不够就用估算值,不必强行实例化)。 -
在
generate_text_simple里把argmax换成torch::multinomial随机采样,观察输出稳定性的变化——这就是第 5 章解码策略的入口。 -
数一数 GPTModel 里的三处 dropout (
drop_emb/ 每块的drop_shortcut/ MHA 内部),运行时输出已给出答案。 -
把
LayerNormImpl的unbiased=false改成true,对随机输入重跑 实测,观察 mean/var 偏差变化——再想想为什么第 5 章加载官方权重前 必须改回去。
拓展阅读
-
He et al., 2015, Deep Residual Learning for Image Recognition(残差连接原始论文): https://arxiv.org/abs/1512.03385
-
Hendrycks & Gimpel, 2016, Gaussian Error Linear Units (GELUs)(GELU 原始论文): https://arxiv.org/abs/1606.08415
-
Radford et al., 2019, Language Models are Unsupervised Multitask Learners(GPT-2): https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
-
Brown et al., 2020, Language Models are Few-Shot Learners(GPT-3,架构与 GPT-2 基本相同的出处): https://arxiv.org/abs/2005.14165
-
GPT-2 官方模型卡(权重下载,第 5 章使用): https://huggingface.co/openai-community/gpt2