第 7 章 指令微调:从文本补全到遵循指令
|
本章导读:通过指令微调把文本补全模型改造为遵循指令的模型, 并以 LLM-as-a-judge 完成自动化评估。第 6 章末尾遗留的 「你问它问题,它给你续写」问题,在本章解决。 学完本章你将能够:
产出与代码: |
7.1 原理概述:指令微调改的是「目标」,不是「模型」
第 6 章的分类微调动了结构:把 50257 维输出头整个换成一个
Linear(768, 2) 二分类头。指令微调不改模型结构——还是那个带 50257
输出头的 GPTModel,一行代码都不动。变的只有三处:
-
数据形态:每条样本是 (instruction, input, output) 三元组,拼成 Alpaca 风格的提示词文本;
-
损失掩码:填充词元用
ignore_index=-100从损失里剔除—— 这是本章最核心的一个数字; -
参数范围:355M 参数全部可训练。用 GPT-2 medium 而非 small, 因为 124M 撑不起指令跟随所需的泛化。
一句话概括差异:预训练教模型「下一个词是什么」,指令微调教模型 「用户要我做什么」——前者是语言建模,后者是任务对齐。典型应用: 聊天机器人、个人助理、对话任务。
为什么这次不用 124M?分类微调是「专业化」——把模型收窄到一个判别 问题上,小容量也能胜任;指令跟随是「泛化」——要同时覆盖拼写、语法 纠正、常识问答等一批异质任务。Stanford Alpaca 做同样的工作,用的是 LLaMA 7B:指令跟随所需的泛化能力对参数规模有硬要求。
本章流程分三阶段:① 准备数据集(下载 → 格式化 → 分批,7.2–7.4); ② 模型配置、微调与生成(7.5–7.6);③ 性能评估(打分,7.7–7.8)。 批处理与掩码(7.3)最容易出错,是本章的重点。
完整流水线如下:

7.2 数据准备:Alpaca 三元组与模板
第一步是准备数据。本教程使用 1100 条 JSON 三元组
(配套数据集 data/instruction-data.json):
{
  "instruction": "Identify the correct spelling of the following word.",
  "input": "Ocassion",
  "output": "The correct spelling is 'Occasion.'"
}三个字段分工明确:instruction 是任务描述,input 是可选附加材料,
output 是期望回复。这个格式出自 Stanford Alpaca,后来几乎所有开源
指令数据集都沿用了它。Alpaca 的成本数据值得记一笔:52K 条指令数据用
self-instruct 方法从 175 条人工种子出发、由 text-davinci-003 自举
生成,数据成本低于 500 美元;微调 LLaMA 7B 在 8 张 A100 上训练
3 小时,算力成本低于 100 美元。指令微调的门槛没有想象中高。
format_input 把三元组拼成 Alpaca 提示词模板;input 为空时,整个
# Input: 小节都会省去:
inline std::string format_input(const InstructionEntry& entry) {
    std::string instruction_text =
        "Below is an instruction that describes a task. "
        "Write a response that appropriately completes the request."
        "\n\n### Instruction:\n" + entry.instruction;
    std::string input_text =
        entry.input.empty() ? "" : ("\n\n### Input:\n" + entry.input);
    return instruction_text + input_text;
}
// 训练文本 = format_input + "\n\n### Response:\n" + output
这段硬编码的英文模板是模型唯一能看到的「任务说明书」:训练时怎么拼, 推理时就得怎么拼,必须逐字符一致。
数据按 85/5/10 划分(train/val/test):train 935 / val 55 / test 110。
7.3 custom_collate_fn:动态填充与 -100 掩码
指令数据长短参差,批处理方式直接决定损失计算是否正确。
custom_collate_fn(include/instruction.h)是本章的核心:它负责
按批填充、构造目标序列、给填充词元加掩码。
与第 6 章「统一填充到 120」不同,这里每个批次填充到本批最长序列 (省算力),并且目标序列要做两件精细的事:
// include/instruction.h —— custom_collate_fn
new_item.push_back(pad_token_id);            // 1. 句尾补一个 <|endoftext|>
while (new_item.size() < batch_max_length)
    new_item.push_back(pad_token_id);        // 2. 填充到批次最长
// 3. 目标左移一位
std::vector<int64_t> inputs(new_item.begin(), new_item.end() - 1);
std::vector<int64_t> targets(new_item.begin() + 1, new_item.end());
// 4. 掩码:除第一个 pad 外,所有 pad 替换为 -100
bool first_pad_seen = false;
for (auto& t : targets) {
    if (t == pad_token_id) {
        if (first_pad_seen) t = ignore_index;   // -100
        first_pad_seen = true;
    }
}
用示例批次 {[0..4], [5,6], [7,8,9]} 逐值验证(demo 的实际输出):
inputs:  [[0, 1, 2, 3, 4], [5, 6, 50256, 50256, 50256], [7, 8, 9, 50256, 50256]]
targets: [[1, 2, 3, 4, 50256], [6, 50256, -100, -100, -100], [8, 9, 50256, -100, -100]]这个函数可以按三个草稿逐步实现,每一步增加一个职责:
-
草稿一(只做填充):
batch_max_length = max(len(item)+1)里的+1先为结束符预留一个位置;填充到统一长度后,padded[:-1]把 最后一个词元截掉作为输入,目标序列因此自然地以结束符结尾; -
草稿二(加目标):唯一改动是
targets = padded[1:]左移一位—— 与第 2 章GPTDatasetV1、第 5 章预训练完全一致; -
最终版(加 -100 掩码):
targets[indices[1:]] = ignore_index—— 跳过索引 0,屏蔽索引 1 之后的所有 pad。
|
为什么保留第一个 pad、掩掉其余? 目标序列里的填充词元有两个身份:
同一个数字能身兼两职:第一个 pad 紧跟回复的最后一个真实词元,模型在 这里学到「该收尾了」;它后面的 pad 只用于对齐长度,对它们计算损失 等于教模型输出无意义内容,既浪费又有害。
|
损失计算因此比第 5 章多一个选项(src/main.cpp):
return torch::nn::functional::cross_entropy(
    logits.flatten(0, 1), target_batch.flatten(),
    torch::nn::functional::CrossEntropyFuncOptions().ignore_index(-100));
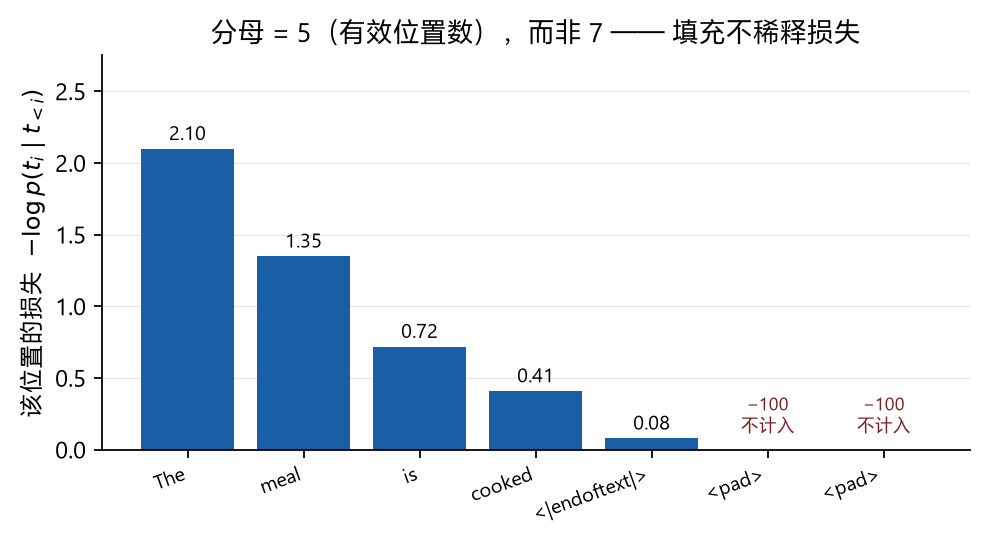
与第 5 章的交叉熵只差一个掩码:分母只数有效位置,-100 的位置既不 产生损失,也不稀释平均:
逐位置画出来就是:蓝色的位置进分子也进分母,灰色的填充位置两边都不进。
batch_size=8、allowed_max_length=1024 截断后:116 train / 7 val /
14 test 个批次,每批长度各不相同([8,87] [8,67] [8,71] …)——
动态填充生效。
|
指令部分的损失:掩码还是不掩码?——一个尚未定论的研究问题。掩码派认为只对回复计算损失能聚焦「生成准确回复」、减少 过拟合;不掩码派(Shi 等 2024,Instruction Tuning With Loss Over Instructions,NeurIPS 2024)发现不掩码反而提升性能:在 21 个 多样化基准上多数提升,最佳情况下 AlpacaEval 1.0 提升超过 100%。机制 指向减少对微调数据集的过拟合,在指令长、输出短、低资源的场景下 尤其有效。本教程选择不掩码指令部分,练习 7.2 让你自己试掩码版本。 不要把任何一边当成既定的最佳实践。 与第 6 章的损失对比,两种微调在损失计算上根本不同:
|
7.4 加载 GPT-2 medium(355M)
微调前先测基线:不记录微调前的输出,提升就无从谈起。加载逻辑与 第 5/6 章同一套 safetensors 代码,只是配置升级:
ch4::GPTConfig cfg;
cfg.context_length = 1024;
cfg.drop_rate = 0.0;
cfg.qkv_bias = true;
cfg.emb_dim = 1024;      // 768 → 1024
cfg.n_layers = 24;       // 12 → 24
cfg.n_heads = 16;        // 12 → 16
ch4::GPTModel model(cfg);
load_gpt2_weights(model, data_dir + "/gpt2-medium.safetensors");  // 1.52 GB
这是第 4 章「超参结构体」设计的回报:换模型不改一行模型代码。
微调前在 val_data[0](「把主动句 The chef cooks the meal every day
改成被动语态」)上测基线。模型只是复述输入,没有执行指令:
### Response:
The chef cooks the meal every day.
### Instruction:
Convert the active sentence to passive: 'The chef cooks the
要求改被动语态,它把题目原样抄了一遍——这是未做指令微调的基座模型的 真实水平:预训练目标里没有「指令」这个概念,它自然不知道指令意味着 什么。
7.5 微调:AdamW 2 轮
训练采用全参数微调:lr=5e-5, weight_decay=0.1,eval_freq=5,
eval_iter=5;每轮结束在固定指令上生成回复,便于人工检查:
torch::optim::AdamWOptions options(5e-5);
options.weight_decay(0.1);
auto optimizer = torch::optim::AdamW(model->parameters(), options);
ch5::generate(model, encoded, /*max_new_tokens=*/100, /*context_size=*/1024,
              /*temperature=*/0.0, /*top_k=*/c10::nullopt, /*eos_id=*/50256);
初始损失与实测训练曲线(355M 参数全部可训练,RTX 4080 约 3-4 分钟):
Training loss: 3.85124
Validation loss: 3.76193

Ep 1 (Step 000000): Train loss 2.609, Val loss 2.590
Ep 1 (Step 000005): Train loss 0.930, Val loss 1.095
Ep 1 (Step 000115): Train loss 0.522, Val loss 0.657
Ep 2 (Step 000230): Train loss 0.373, Val loss 0.674
2 轮结束后,同一个指令的回复变成(在 eos 处精确停止):
### Response: The meal is cooked every day by the chef.<|endoftext|>前后对照清晰:从复述输入到正确作答,只隔了 2 轮训练。注意输出末尾的
<|endoftext|>——7.3 节保留的第一个 pad,在这里兑现成「说完就停」
的能力。
|
为什么只训 2 轮?损失已降到较低水平,延长到第三轮并无必要,甚至 可能加剧过拟合。对比第 6 章的 5 轮:差异来自数据集规模与任务难度。 损失曲线解读:初期快速下降(2.609 → 0.930 只用 5 步——模型迅速 捕捉到有意义的模式);第二轮放缓(在已学特征上收敛到稳定解)。第 2 轮末 train 0.373 / val 0.674——训练损失持续降而验证损失停在 0.67 附近,说明第二轮已开始轻微过拟合。 与第 5 章预训练「train 0.67 / val 6.42 的巨大分叉」相比,这里的 train/val 差距小得多——训练目标变了:不是教模型记住数据集,而是 教它格式(看到 # Response: 就输出回答,说完就停)。 |
7.6 生成、抽取与保存
训练完成后进入验收。对全部 110 条测试样本贪心解码
(temperature=0.0 + eos_id=50256,max_new_tokens=256);用
extract_response 从生成文本里切出回复(include/instruction.h),
存成 instruction-data-with-response.json。前 3 条对比:
1) 明喻:   正确 "as fast as lightning"   模型 "as fast as a cheetah"  (合理)
2) 雷暴云: 正确 cumulonimbus             模型 cumulus clouds           (同样的近似错误)
3) 作者:   正确 Jane Austen              模型 ...is Jane Austen        (几乎一致)
模型学到的是「任务语义」而非「背答案」:第 2 条的错误只是近似类别上的
偏差,属于模型能力边界,不是实现 bug。调试训练工程时,
先分清「模型不会」和「代码写错」。权重存为 gpt2-medium355M-sft.pth。
回复质量如何量化,是下一节的主题。
7.7 LLM-as-a-judge:Ollama 自动评分
分类任务有准确率这样的客观指标;对话性能(理解上下文、细微差别与 意图,与人自然沟通的能力)没有唯一标准答案。常用三类主流方法:
| 方法 | 代表 | 考查内容 |
|---|---|---|
短答案与多选基准 |
MMLU |
综合知识 |
人类偏好比较 |
LMSYS 聊天机器人竞技场 |
人类主观偏好 |
用其他 LLM 自动评估 |
AlpacaEval |
对话性能 |
人工评估 110 条回复成本过高;基准测试考察知识,考察不了指令跟随。
本章采用类 AlpacaEval 的自动化方法:让本地大模型当裁判
(query_ollama 通过 http://localhost:11434/api/chat 调用,
seed=123, temperature=0 尽量保证评分稳定):
std::string prompt =
    "Given the input `" + format_input(e) + "` and correct output `" +
    e.output + "`, score the model response `" + e.model_response +
    "` on a scale from 0 to 100, where 100 is the best score. "
    "Respond with the integer number only.";
std::string score = query_ollama(prompt);      // 裁判:llama3
评分提示词末尾的 "Respond with the integer number only" 让裁判返回
可解析的整数;但解析处的异常护栏(C++ 的 try/catch)仍是必要的——
LLM 偶尔不遵守「只返回整数」的指令。
前置条件(脚本已在第 0 章备好):
./scripts/start-ollama.sh --pull # 启动 ollama serve + 拉取 llama3(4.7 GB)全量 110 条的实测评分是平均 50.32。这个数字要放进参照系里看:
| 模型 | 平均分 |
|---|---|
本章微调的 GPT-2 medium (355M) |
50.32 |
Llama 3 8B 基础模型(未指令微调) |
58.51 |
Llama 3 8B 指令模型 |
82.6 |
50.32 不是亮眼成绩,但它是本教程教学规模(1100 条数据 + 355M 模型
2 轮训练)下的合理基线;82.6 的商用级指令模型在数据规模与训练投入上
都远超本教程设置。可用的提升策略有四条:调超参(lr/批次/轮数)、
增加数据规模与多样性、尝试不同提示词格式、换更大的预训练模型。
解读分数时还要考虑裁判自身的非确定性。实测的前 3 条样例打分 85 / 40 / 95(平均 ≈ 73),而全量平均才 50.32——可见裁判有随机性, 单次结果仅供量级参考;Ollama 在不同系统上并非完全确定,建议多次 评估取平均。LLM-as-a-judge 是目前成本与质量折中最优的方案,但解读 分数时要把裁判自己的随机性算进去。
7.8 编译运行与预期输出
./scripts/download-data.sh                 # 指令数据集(幂等)
./scripts/download-weights.sh medium       # GPT-2 medium 权重 1.52 GB
./scripts/run.sh chapter07_instruction_tuning           # 默认 2 轮
./scripts/run.sh chapter07_instruction_tuning 0        # 0 轮:只看数据管道与微调前基准
验收关注四个信号:collate 示例逐值一致、loss_3 == loss_1(掩码
生效)、微调前复述输入/微调后正确输出被动句、110 条回复全部落盘。
本章小结
-
指令微调不改变模型结构,改变的是数据形态(Alpaca 三元组)与损失 掩码(ignore_index=-100)——第 6 章换输出头,本章连头都不换。
-
custom_collate_fn 有三个职责:按批动态填充、目标左移一位、掩码 填充词元(保留第一个作为停止信号);-100 的位置既不算损失也不进 分母,loss_3 == loss_1 证明掩码精确生效。
-
GPT-2 medium + 1100 条 Alpaca 数据 + 2 轮微调,即可从复述输入 跃迁到遵循指令;第二轮 train/val 分叉提示轻微过拟合,2 轮后应 停止训练。
-
对话性能评估依赖 LLM-as-a-judge(类 AlpacaEval);裁判具有 非确定性,平均分 50.32 是教学规模下的基线,单次评分只看量级。
-
指令部分掩码与否仍是开放研究问题(Shi et al. 2024:不掩码反而在 低资源场景更优)——默认值也要自己验证。
自测清单
能不回看就答出这些,本章就算过关:
-
1100 条 → 935/55/110,
format_input输出与 7.2 节示例逐字符一致 -
collate 示例批次逐值一致;
loss_3 == loss_1验证-100掩码; 能说出「第一个 pad 保留」的双身份理由 -
116/7/14 个批次,每批长度不同(动态填充生效)
-
初始 loss ≈ 3.85/3.76,2 轮后 ≈ 0.37/0.67(第二轮轻微过拟合可识别)
-
微调前 val_data[0] 复述输入;微调后正确输出被动句且 eos 停止(前后对照)
-
instruction-data-with-response.json110 条、gpt2-medium355M-sft.pth已保存 -
Ollama 全量平均分在 50 上下(本教程实测基准 50.32;裁判有非确定性)
-
能说出「指令部分掩码 vs 不掩码」两派各自的论据与 Shi et al. 2024 的适用条件
习题
-
把 Alpaca 模板换成 Phi-3 风格(
<|user|>\n…<|assistant|>)重新微调, 对比收敛速度——提示词模板本身也是「超参」。 -
把指令部分(# Response: 之前)的目标也掩成 -100,只对回复计算损失, 对比 2 轮后的 val loss。
-
用 Ollama 分别给「微调前模型」和「微调后模型」的回复打分, 量化指令微调前后的差距。
-
贪心(temperature=0)换成 top_k=25 + temperature=1.4 生成测试集回复, 观察评分方差的变化。
拓展阅读
-
Shi et al., 2024, Instruction Tuning With Loss Over Instructions (NeurIPS 2024,不掩码指令部分的实证与适用条件): https://arxiv.org/abs/2405.14394
-
Taori et al., 2023, Stanford Alpaca(52k 指令数据与提示模板): https://arxiv.org/abs/2303.16147 | 官方博客(<$600 成本明细): https://crfm.stanford.edu/2023/03/13/alpaca.html
-
Wang et al., 2023, Self-Instruct(自举生成指令数据的开山做法,ACL 2023): https://arxiv.org/abs/2212.10560
-
Ollama 官网(本地运行 llama3 当裁判): https://ollama.com | Llama 3 模型页: https://ollama.com/library/llama3