第 6 章 分类微调:替换输出头的任务适配
|
本章导读:将预训练模型适配为二分类器——替换输出头、冻结绝大部分参数, 在平衡后的 SMS Spam 数据集上完成有监督微调。模型骨架不变,任务从 「预测下一个词元」换成「预测类别标签」。 学完本章你将能够:
产出与代码: |
6.1 原理概述:分类微调还是指令微调
一份 1.24 亿参数的 GPT-2 预训练权重到手,下一步是微调。路线有两条:把输出头
换成 Linear(768, 2) 做垃圾短信分类,或保留 50257 维输出头做指令跟随。
不少初学者默认后者才是「正经 LLM 该干的事」。实际上两条路线没有高下之分,
选择依据是任务形态。「预训练 + 微调」范式由 GPT-1 论文(Radford et al., 2018)
确立:先在海量无标注文本上自监督预训练,再用少量标注数据微调到具体任务。
这一范式沿用至今。同一份权重,两条微调路线:

两条路线的完整对照——选哪条,凭任务形态:
| 维度 | 指令微调(第 7 章) | 分类微调(本章) |
|---|---|---|
训练数据 |
带指令的多任务样本 |
固定类别标签的样本 |
模型能力 |
理解并执行自然语言提示描述的任务 |
只识别训练时见过的那几个类别 |
输出形态 |
自由文本(翻译、改写、问答) |
一个类别标签 |
通用性 / 需求 |
高,可应对多任务;数据与算力需求更大 |
低,高度专业化;需求更少 |
一种常见观点认为「专才模型是妥协,通用模型才是终极形态」。对固定类别的任务, 结论恰恰相反:若任务就是把输入归到预定义类别(情感分析、垃圾检测), 分类微调更合适——训练更快、部署更省、结果可直接量化。用指令微调模型做 垃圾短信分类并非不可行,但训练、部署与推理每一环都在多付成本,输出还要 再做一步判定才能当类别用。三条必须记住的判断:
-
经过分类微调的模型只会预测训练中遇到的类别——它不会解释、不会总结、 不会回答别的问题;输入也不需要额外指令。它只服务于这一类任务;
-
分类微调模型 = 高度专业化模型,而开发专业化模型比开发通用模型简单;
-
选型准则:要应对多任务、依赖复杂指令 → 指令微调;要精确归到预定义 类别(情感分析、垃圾检测)→ 分类微调。
分类微调与预训练的三个本质差异:
-
标签是外部给的(ham/spam),不再是「输入右移一位」;
-
只取最后一个词元的输出——因果注意力让最后一个位置的 hidden state 覆盖整个序列,它天然充当序列的摘要(6.5 节细说);
-
冻结大部分参数:千余条样本要拟合 1.24 亿参数,平均下来每条样本只能 把每个参数改动零点零零几——信号太弱,全部参数一起动只会把预训练学到的 语言表征覆盖掉,剩下的新梯度又不够把这些参数重新校准到新任务上。冻结 浅层与中间层,只留最后几层可训练,让可动参数收缩到样本量能撑住的范围 (6.4 节细说)。
6.2 数据准备:4825 条 ham 只留 747 条
UCI 的 SMSSpamCollection 数据集共 5572 条真实短信:ham 4825 条, spam 747 条,spam 仅占 13.4%。这个比例接近真实分布,但直接拿去训练分类器会引入偏置: 模型会偏向多数类,不学任何特征、恒猜 ham,准确率也有 86% (4825/5572 ≈ 86.6%)。这样的模型抓不到一条垃圾短信,高准确率毫无意义。 准确率指标在类别不平衡时会失真,所以第一步先做平衡:
// include/finetuning.h —— create_balanced_dataset
std::vector<SpamItem> ham, spam;
for (const auto& it : data) (it.label == 1 ? spam : ham).push_back(it);
std::mt19937 rng(seed);                       // seed=123,固定随机种子
std::shuffle(ham.begin(), ham.end(), rng);
ham.resize(spam.size());                      // ham 下采样到 747
平衡后 1494 条,标签数值化(ham→0, spam→1——和把文本转成词元 ID 是
一回事,只不过「词表」从 50257 缩到 2 个 ID),再按 70/10/20 随机划分
并落盘:train.csv(1045)/ validation.csv(149)/
test.csv(300)。
|
三个容易忽略的细节:
|
6.3 SpamDataset:填充、截断与统一长度
第 2 章用滑动窗口切出等长文本块,长度天然一致;本章面对的是长度不一
的短信。变长序列无法直接拼成张量,必须先统一长度。两条路:全部截断到
最短消息长度(省算力,但最短消息远短于平均长度时丢信息),或全部填充到
最长消息长度(保留全部内容,计算量更大)。本教程选填充,
填充词元用 <|endoftext|>(ID 50256)。填充不丢任何文本,代价是为填充
位置多付计算——这是「先跑通,再优化」的取舍。
一个实现细节容易出错:填充不是把字符串 "<|endoftext|>" 拼到文本后面
再分词,而是先对原始文本分词,再把 ID 50256 追加到编码结果后面——
避免填充词元影响分词器对文本本身的切分。
每个文本 BPE 编码后填充到统一长度:
class SpamDataset {
public:
    SpamDataset(const std::string& csv_path, ch2::BpeTokenizer& tokenizer,
                int64_t max_length = -1, int64_t pad_token_id = 50256) {
        for (const auto& it : data_)
            encoded_texts_.push_back(tokenizer.encode(it.text));
        if (max_length < 0)
            max_length_ = longest_encoded_length();       // 以训练集最长者为基准
        else {
            max_length_ = max_length;                     // val/test 沿用训练集的长度
            for (auto& e : encoded_texts_)                // 超长截断对齐
                if ((int64_t)e.size() > max_length_) e.resize(max_length_);
        }
        for (auto& e : encoded_texts_)
            e.resize(max_length_, pad_token_id_);         // 尾部填充
    }
};
能不能让 val/test 各用各的最长长度?不能。三个数据集必须用同一个
max_length(train 取最长样本长度 = 120,val/test 截断对齐)——
必须用训练集的长度约束验证/测试集。同一模型在不同 max_length 下评估,
指标不可比,调参将失去依据。batch_size=8 后得到
130 train / 19 val / 38 test 个批次,每个批次是 inputs=[8,120], labels=[8]。
|
drop_last 的不对称是刻意的:train 1045 条 → 顺带一提: |
|
填充发生在尾部,会不会污染分类结果?不会——因果注意力保证填充词元 不影响前面真实词元的表示;分类头读的最后一个位置虽然常是填充词元, 但它仍能看到之前的全部真实文本(6.5 节细说)。不过填充本身未加屏蔽 (本实现的 padding 位置同样参与 attention,没有 pad mask)——这是简化, 工业实现会加 padding mask。教学版本省略这层防护以保持代码可读, 实际项目应补上。 |
6.4 替换输出头:仅训练 5.7% 的参数
把预训练 GPT-2 改造成分类器,代码改动很小:复用整个 GPTModel
(引用同一模块,不复制权重),换掉输出层,再精确控制哪些参数可训练:
class GPTClassifierImpl : public torch::nn::Module {
public:
    GPTClassifierImpl(ch4::GPTModel& base, int64_t num_classes) {
        base_ = base;                                    // 引用同一模块
        register_module("base", base_);
        out_head_ = register_module("out_head",
            torch::nn::Linear(emb_dim, num_classes));    // 768 → 2

        for (auto& np : base_->named_parameters())       // 1. 全部冻结
            np.value().set_requires_grad(false);
        auto& last = base_->trf_blocks->at<ch4::TransformerBlockImpl>(
            base_->trf_blocks->size() - 1);
        for (auto& np : last.named_parameters())         // 2. 解冻最后一个块
            np.value().set_requires_grad(true);
        for (auto& np : base_->final_norm->named_parameters())
            np.value().set_requires_grad(true);          // 3. 解冻 final_norm
    }
    torch::Tensor forward(torch::Tensor x) {
        auto hidden = base_->forward_hidden(x);          // [b, n, 768](不接 out_head)
        return out_head_->forward(hidden);               // [b, n, 2]
    }
};
换头是操作,冻结是设计的关键。1045 条微调样本撑不起 1.24 亿参数的训练: 全部解冻时,梯度会冲掉预训练学到的语言知识,模型记住的是这 1045 条训练 样本本身,学不到可泛化的判别规则——这是典型的过拟合。冻结策略的三层逻辑:
-
为什么冻结:神经网络的较低层捕捉通用语言结构与语义,最后几层 更侧重细微的语言模式和任务特定特征——只微调最后几层通常就够了, 而且计算更高效;
-
为什么还要多解冻一块:技术上只训新加的分类头就足够,但实验发现 微调额外的层(最后一块 + final_norm)能显著提升预测性能;
-
冻结范围要圈准:新层的
requires_grad默认为 true,是安全起点; 上面代码的冻结遍历特意只圈base_的参数、新换的out_head_不在 名单里——若把整个模型一遍冻完,新头会被一起冻住,可训练参数归零, loss 纹丝不动,训练全程作废。
可训练参数的精确账本——此时模型总参数为 124,441,346(qkv_bias=true、输出头 已换成 2 类头,故不再是第 4 章的 163M 口径),其中 94.3% 保持冻结,仅 5.7% 参与训练:
| 组件 | 参数量 | 可训练? |
|---|---|---|
tok_emb(50257×768) |
38,597,376 |
❌ |
pos_emb(1024×768)+ 前 11 个块 |
786,432 + 77,966,592 |
❌ |
最后 1 个 Transformer 块 |
7,087,872 |
✅ |
final_norm |
1,536 |
✅ |
新 out_head(768×2 + 2) |
1,538 |
✅ |
合计可训练 |
7,090,946 |
占总参数 5.70% |
这是参数高效微调的雏形——第 9 章的 LoRA 会把这个比例再压低六成多 (2.10%,且精度不掉),本章算是它的思想预习。
|
C++ 细节:优化器只接收 |
6.5 只看最后一个词元:分类损失与准确率
分类头的输入是整条短信(填充到 120 个词元),但它只读最后一个词元的 隐藏状态。初看这个设计,一个自然的问题是:前面 119 个词元的信息怎么办?
信息没有丢。钥匙是第 3 章的因果注意力:掩码保证第 i 个词元只能看到 \(\le i\)
的位置;最后一个词元因此见过前面全部词元,它的隐藏状态
相当于整句的压缩摘要。分类头读的不是最后一个字,而是浓缩在最后一个位置的
整句话。与预训练损失相比,代码只改了一行——索引 -1 取序列最后位置:
inline torch::Tensor calc_loss_batch(const torch::Tensor& input_batch,
                                     const torch::Tensor& target_batch,
                                     GPTClassifier& model) {
    auto logits = model->forward(input_batch).index(
        {torch::indexing::Slice(), -1, torch::indexing::Slice()});  // [b, 2]
    return torch::nn::functional::cross_entropy(logits,
                                                target_batch.to(logits.device()));
}
calc_accuracy_loader 同理:argmax 后与标签比对,
GPU 上比较前要 .to(torch::kCPU)。
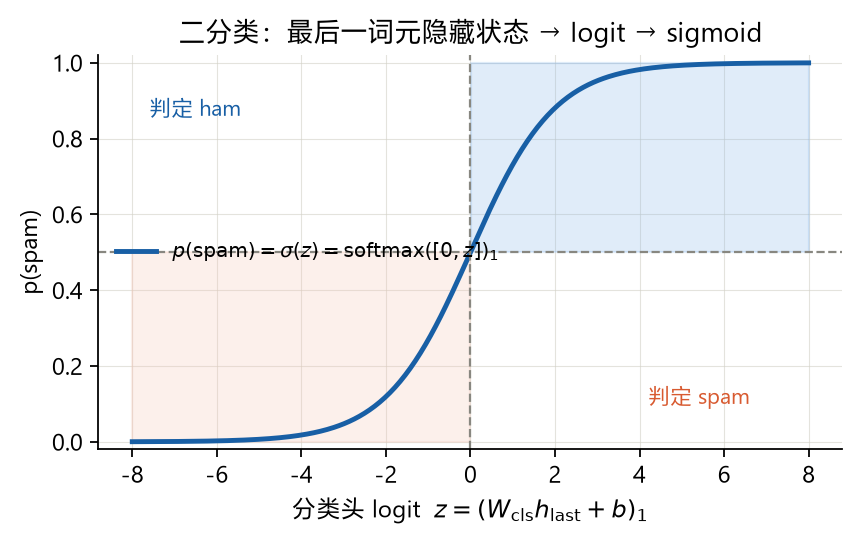
两条公式概括本节。分类头读最后一个词元的隐藏状态,输出两个 logit:
损失仍是交叉熵,二分类下等价于只看真实类别那一支的对数概率:
二分类的 softmax 就是一条 sigmoid——logit 过零即决策边界:
|
为什么用交叉熵而不是直接优化准确率?因为分类准确率不可微——它依赖 argmax,梯度处处为 0,无法反向传播。交叉熵是它的可微代理: 优化交叉熵,准确率随之提升。 微调前的基线怎么读:各取 10 批(80 样本)的初始准确率 46.25% / 45.00% / 48.75%——全部略低于 50%(二分类随机猜测基线),说明随机初始化的分类头 还没有判别能力,属正常现象。初始损失 2.453 / 2.583 / 2.322 明显高于 ln(2) ≈ 0.693 的「随机基线」,但这不代表模型有问题:新分类头随机 初始化导致 logits 尺度很大(如 7.45),交叉熵对「自信的错误」惩罚极重。 这也解释了损失为何能从前 50 步的 2.15 降到 0.62——头几步把 logits 尺度压回正常区间,惩罚随即松动。 |
为什么取最后一个词元值得再强调一次:因果注意力掩码(第 3 章)保证 第 i 个词元只能看到 \(\le i\) 的位置——最后一个词元是唯一能访问前面所有 词元的位置,所以它天然充当整句的压缩表示。
但有一个潜在问题需要明确:所有样本都右侧填充到 120,短消息的
最后一个位置其实是填充词元而非真实文本——用填充位置做分类可靠吗?
好在填充词元通过因果注意力仍能看到之前的全部真实词元,信息没有丢失,
这种做法仍然成立。但若把 max_length 拉到 1024(练习 6.1),
最后一个位置离真实文本末尾隔着近千个填充词元,判别信号将严重稀释。
这是练习 6.1 预期「性能显著下降」的第一原因(其余两个:注意力计算量随 \(L^2\) 增长
(长度 ×8.5,计算量 ×73);分类头要从一个纯填充位置提取全部判别信息)。
「只取最后一个词元」成立的前提,恰恰是 120 这个贴近真实文本长度的
max_length——最后一个位置离真实文本足够近。
6.6 微调训练循环:学习率下调,按样本计数
骨架与第 5 章完全相同(zero_grad → forward → backward → step), 变化集中在超参与监控指标。训练循环与预训练版的差异可以列成一张表:
| 维度 | 第 5 章 train_model_simple |
本章 train_classifier_simple |
|---|---|---|
跟踪累计量 |
|
|
每轮末的监控 |
打印生成的文本样本 |
计算训练/验证准确率 |
损失计算 |
全部词元 |
仅最后一个词元 |
优化目标 |
预测下一个词元 |
预测类别标签 |
三个超参变了:lr=5e-5(比预训练的 4e-4 低了将近一个数量级——学习率过大
会破坏预训练学到的语言表示,微调阶段必须明显调低)、eval_freq=50、
按样本数统计(examples_seen 而非 token 数——分类任务一个样本才
产出一个标签):
torch::manual_seed(123);
torch::optim::AdamWOptions options(5e-5);
options.weight_decay(0.1);
auto optimizer = torch::optim::AdamW(classifier->trainable_parameters(), options);
ch6::train_classifier_simple(classifier, train_loader, val_loader, optimizer,
                             /*num_epochs=*/5, /*eval_freq=*/50, /*eval_iter=*/5);
注意配置变化:微调时 drop_rate = 0.0(关闭 dropout)、qkv_bias = true、
context_length = 1024(与官方权重一致)。
|
读训练日志的两条纪律:
轮数怎么选:没有通用解,5 轮通常是合理的起点。前几轮就过拟合 → 减轮数;验证损失仍在下降 → 加轮数。本章取 5 轮的依据: 没有早期过拟合迹象,且验证损失已接近 0。 |
6.7 编译运行与预期输出:从 46% 到 97%
./scripts/run.sh chapter06_finetuning关键输出(横幅编号为程序内的演示序号,与本章小节号略有错位):
=== 6.2 准备数据集
总样本数: 5572
标签分布: ham = 4825, spam = 747
平衡后: ham = 747, spam = 747(总计 1494)
划分: train = 1045, val = 149, test = 300

=== 6.3 创建数据加载器
训练集 max_length = 120
批次数量: 130 training, 19 validation, 38 test

=== 6.4 初始化带有预训练权重的模型
生成文本: Every effort moves you toward finding an ideal new way to practice
指令输入生成(未微调,不遵循指令): ...(续写文本,不会回答 yes/no)

=== 6.6 计算分类损失和准确率
Training accuracy: 46.25% | Validation accuracy: 45.00% | Test accuracy: 48.75%
Training loss: 2.453 | Validation loss: 2.583 | Test loss: 2.322

=== 6.7 在有监督数据上微调模型
Ep 1 (Step 50): Train loss ..., Val loss ...    ← 每 50 步评估一次损失
每轮末尾另打印一行准确率(分母 40 = eval_iter 5 × batch 8,2.5% 步进,
只能看趋势):训练准确率从 60% 附近起步,第 5 轮升至 95% 附近,
验证集同步上行到 92% 附近

=== 6.8 使用大语言模型作为垃圾消息分类器
text_1: You are a winner you have been specially selected to receive $1000 cash ...
分类结果: spam
text_2: Hey, just wanted to check if we're still on for dinner tonight? ...
分类结果: not spam
已保存分类模型到 data/review_classifier.pth微调结束后的全量评估(不设 eval_iter,跑完所有批次)应达到:
| 数据集 | 准确率 | 正确数 / 总数 |
|---|---|---|
Training |
97.21% |
1011 / 1040 |
Validation |
97.32% |
145 / 149 |
Test |
95.67% |
287 / 300 |
从 46% 到 97%,只用了 5 轮 × 1045 条样本——预训练依赖海量无标注数据,
微调只需要少量高质量标注样本。验证集略高于测试集是常见现象——模型开发
过程中会反复调整超参以提升验证集性能,这些针对验证集的调整对测试集不完全
适用。缩小差距的手段:加大 drop_rate 或优化器的 weight_decay。
|
程序输出里 6.4 一段的「指令输入生成」实验值得多看一眼:给未微调的 GPT-2 输入
另一个交付侧的要点: |
本章小结
-
分类微调 = 替换输出头 + 冻结绝大部分参数 + 只读最后一个词元的表示;选型看任务形态:要一个标签选分类,要自由文本选指令微调。
-
数据工程三步:下采样平衡(5572 → 1494)、标签数值化、70/10/20 划分;恒猜多数类即得 86% 准确率,说明不平衡数据下准确率会失真。三个数据集必须共用训练集的 max_length=120。
-
可训练参数仅 7,090,946(占 5.70%);冻结范围只圈 base、新头不在名单(可安全先换头),整个模型一遍冻完漏掉新头则可训练参数归零,训练全程作废。
-
只取最后一个词元成立的前提是因果注意力 + 填充层足够薄;交叉熵是准确率的可微代理,初始 loss 高于 ln(2) 的原因是 logits 尺度大、错罚更重,而非模型学得差。
-
训练四要素:lr 低一个数量级(5e-5)、按样本计数、监控准确率、轮数看验证集。准确率从 46% 提升到 97%(test 95.67%),依赖预训练特征与最后一块的联合微调。
自测清单
能不回看就答出这些,本章就算过关:
-
数据三件套:5572 → 平衡 1494 → 1045/149/300,CSV 已落盘
-
130/19/38 个批次,
max_length=120,padding 用 50256 (train drop_last 丢 5 条 → 实训 1040 条) -
可训练参数 7,090,946(5.70%),并能说出冻结范围为什么只圈 base—— 整个模型一遍冻完、漏掉新头会发生什么
-
微调前准确率 ~46%(略低于 50% 随机基线), loss ≈ 2.4–2.6 并能解释为何高于 ln(2)
-
5 轮后 val accuracy ≥ 92%,全量评估 test ≈ 95.7%
-
classify_review正确判别 winner 短信为 spam、dinner 短信为 not spam (与 6.4 前后对照) -
review_classifier.pth已保存
习题
-
把
unfreeze_all()打开(全部 1.24 亿参数可训练),对比 5 轮后的 val accuracy 与过拟合情况——冻结策略到底防住了什么? -
把硬编码为 2 的
num_classes改成其他数量(例如 3 类新闻), 重新编译并体会Linear(768, 2)中 2 的来源。 -
把
eval_iter从 5 改成全部批次(130),观察评估精度与耗时的取舍。 -
对比
lr=5e-5与lr=5e-4:学习率放大 10 倍后微调还稳吗? -
用
test_loader完整跑一遍calc_accuracy_loader, 把 test accuracy 精确到小数点后两位。 -
把三个数据集的
max_length拉到 1024 重新训练, 验证「性能显著下降 + 训练变慢」,并说出三个原因(信号稀释、\(\mathcal{O}(L^2)\)、 分类头退化为对填充位置分类)。
拓展阅读
-
UCI SMS Spam Collection 数据集官方页(Almeida et al., 2011,本章数据来源): https://archive.ics.uci.edu/dataset/228/sms+spam+collection
-
Radford et al., 2018, Improving Language Understanding by Generative Pre-Training(「预训练 + 微调」范式的出处,GPT-1): https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
-
GPT-2 官方模型卡(1.24 亿参数与预训练权重下载): https://huggingface.co/openai-community/gpt2