第 8 章 训练工程化:预热、余弦衰减与梯度裁剪
|
本章导读:第 5 章的 学完本章你将能够:
产出与代码: |
8.1 train_model_simple 省略了什么
第 5 章的 train_model_simple 跑完了,loss 也降了。但别拿这个结果当真——训得太短,5145 个词元、10 轮,没给失败留发生的时间。梯度爆炸、loss 振荡、过拟合这些毛病,在第 5 章里根本没有机会冒头;名字里的 simple 就是说这一件事:作者拿掉了一切让训练不崩的工程手段——学习率调度、梯度裁剪、训练观测——这些本章要补齐。
省略的代价有实测数字。随机初始化的 GPT-2 124M(cross-entropy、batch 2×256),第一个 batch 的梯度范数实测 1.80,已经越过裁剪阈值 max_norm=1.0;本章演示程序(缩小版模型)实测 1.68–1.71。数值不大,但每一步都压着阈值走:没有裁剪时,任何一次梯度异常都会全额进入更新。个别异常 batch 把范数顶到数十倍以上的情形,在长训练里并不罕见——裁剪就是把这种尾部风险封顶的保险。
省掉的每一样都对应一种真实的失败方式,本章的三道保险按失败方式逐个配置:

三道保险各对应一种失败:线性预热让 lr 从 0 爬到峰值,防「前几步就训崩」;余弦衰减把 lr 平滑降到地板,防「后期在最优解附近震荡」;梯度裁剪给全体梯度范数封顶,防「个别 batch 梯度爆炸」。三道齐备,就是 8.2 到 8.4 要实现的 train_model。
8.2 学习率调度:线性预热与余弦衰减
现代 LLM 预训练的学习率曲线,核心是一个函数、三段分支。它就是 include/training_D.h 里的 get_lr:
inline double get_lr(int64_t step, double warmup_steps, double max_steps,
                     double lr_min, double lr_max) {
    // 1) 线性预热:lr 从 0 爬到 lr_max(step+1 保证第一步不是 0)
    if (step < warmup_steps) {
        return lr_max * (static_cast<double>(step) + 1.0) / warmup_steps;
    }
    // 2) 超过 max_steps:恒定 lr_min(防止 cos 参数变负)
    if (step > max_steps) {
        return lr_min;
    }
    // 3) 余弦衰减:先慢后快地滑向 lr_min
    double decay_ratio = (step - warmup_steps) / (max_steps - warmup_steps);
    double coeff = 0.5 * (1.0 + std::cos(M_PI * decay_ratio));
    return lr_min + coeff * (lr_max - lr_min);
}三段分支各管一件事:step < warmup 时线性预热,lr 从 0 爬到峰值;超过 max_steps 后恒定在地板 lr_min,同时防止余弦参数变负;中间是余弦衰减,先慢后快地滑向地板。
两段各对应一条公式。线性预热(step+1 保证第一步不是 0,且第一步
就有 lr_max/T_warmup 的合法步长):
余弦衰减(progress 表示衰减完成度,从 0 走到 1):
这个组合的设计动机如下:
-
预热针对的问题:训练初期模型参数是随机的,梯度方向噪声大, 一上来就用大学习率会造成大幅度、不稳定的更新。预热步数怎么定? 经验区间是总步数的 0.1% ~ 20%,跨度很大。大模型预训练的 工程惯例常取 1%~2%;本章演示干脆取到 1/3(10/30 步),为了让 曲线在 30 步内看得清;
-
余弦衰减针对的问题:训练后期学习率过大容易越过损失最小值, 在最优附近来回震荡。余弦衰减模拟半个余弦周期的轨迹,把学习率 平滑降到接近零。公式的每一部分都在做一件事:
lr = min_lr + (lr_max − min_lr) × 0.5 × (1 + cos(π × progress))
                                     ─────┬─────    ────────┬─────────
                [−1,1] 归一到 [0,1] ◄────┘                  └─► progress∈[0,1]
                                                                  衰减完成度

progress:  0.00 → 系数 1.000(= lr_max)   0.50 → 0.500(中点)
0.75 → 0.146(接近地板) 1.00 → 0.000(= lr_min)-
地板 lr_min:余弦尾巴自然趋近 0,但训练可能中途加步数——地板保证 lr 永远为正。
这套组合有明确的出处。预热不是 GPT 时代的新发明:2017 年的原版 Transformer 就带了「先预热 4000 步」的机制;余弦退火出自同年 SGDR 论文。 把两者组合成 LLM 预训练默认配置的,是 2020 年的 GPT-3 论文——前 3.75 亿 词元线性预热,之后近 3000 亿词元余弦衰减到峰值的 10%。那 0.125% 的预热 占比,正好落在上述经验区间的下沿。
逐步手算验证调度
演示配置 warmup=10, max_steps=30, lr_max=5e-4, lr_min=1e-6,每一步都能手算:step 0 是 5e-05(lr_max/10);step 20 正好是余弦中点 2.5e-04(cos(π/2)=0,系数 0.5);step 30 落到地板 1e-06。完整调度表如下,建议先自己算一遍再对照:
step  0: 5.00e-05   ← 预热第 1 步(lr_max/10)
step  5: 3.00e-04   ← 预热中段
step  9: 5.00e-04   ← 预热到顶
step 10: 5.00e-04   ← 余弦起点
step 20: 2.50e-04   ← 中点(cos(π/2)=0,系数 0.5)
step 25: 7.41e-05
step 30: 1.00e-06   ← 落到地板
step 35: 1.00e-06   ← 之后恒定
实现里还有一个容易忽略的边界细节。
|
两个实测到的边界细节:① 第一步的 lr 是 0—— |
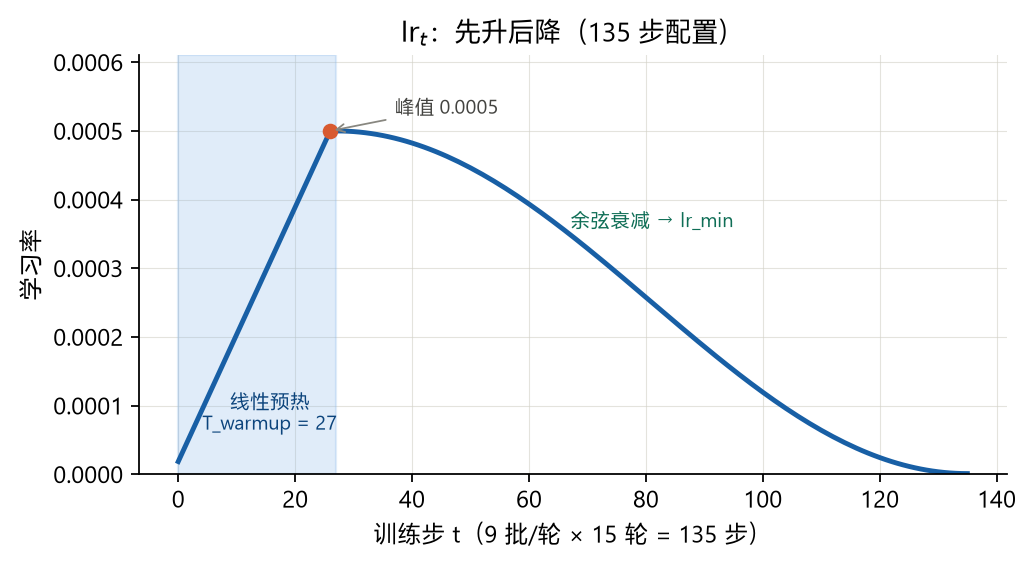
整条曲线(本章叙述用的 135 步配置:warmup=27, max_steps=135, lr_min=1e-6,
即第 5 章数据 9 批/轮 × 15 轮)——蓝域是预热,之后沿余弦滑向地板。注意
仓库演示程序跑的是更小的 30 步调度(warmup=10, max_steps=30, lr_min=1e-6),
见 8.7 节实测输出:
8.3 梯度裁剪:全局 L2 范数封顶
LibTorch 没有 clip_grad_norm_,这个函数需要自己实现。实现之前先读官方语义。PyTorch 文档的原话是:范数按 "as if they were concatenated into a single vector" 计算。翻译过来:把所有梯度拼成一个长向量,算总长。这句话是全部语义的地基。
先算全体参数梯度的总长度,超阈值就等比缩小(include/training_D.h):
inline double calc_norm_of_grads(const std::vector<torch::Tensor>& parameters) {
    double total_sq = 0.0;
    for (const auto& p : parameters) {
        if (p.grad().defined()) {
            auto n = p.grad().norm(2).item<double>();
            total_sq += n * n;
        }
    }
    return std::sqrt(total_sq);
}

inline double clip_gradients(std::vector<torch::Tensor> parameters, double max_norm) {
    double total_norm = calc_norm_of_grads(parameters);
    double clip_factor = max_norm / (total_norm + 1e-5);   // +1e-5 防除零
    if (clip_factor < 1.0) {                               // 只缩不放
        for (auto& p : parameters)
            if (p.grad().defined()) p.grad().mul_(clip_factor);
    }
    return total_norm;                                     // 返回裁剪前范数供观测
}两处易错点都在代码里处理了:+1e-5 防止零梯度时除零得 inf(本实现的
clip_factor < 1.0 守卫会先行挡住 inf,这道保险防的是其他实现路径的
inf×0;PyTorch 官方的常数是 1e-6,思路相同);clip_factor < 1.0 才
缩放——裁剪是安全阀不是放大器,范数正常时一个数都不动。这是
PyTorch torch.nn.utils.clip_grad_norm_ 的手写等价。
从官方语义能推出三个关键性质。原文没有明说,但缺了哪条都容易用错:
-
范数是「全局」算的——官方文档原话:"The norm is computed over all gradients together, as if they were concatenated into a single vector"。 把所有参数的梯度拼成一个向量算一个总范数,不是逐张量裁剪。 设计理由:单看一个张量,无法判断它相对整体是否异常——某一层的梯度 再大,也要放到全体里看占比;
-
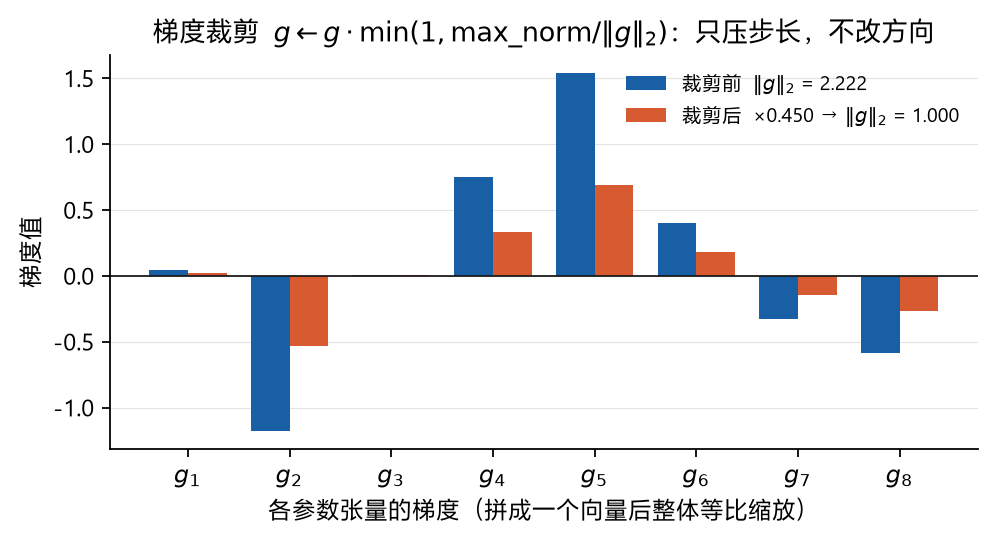
缩放因子全局统一——一旦触发,所有梯度乘同一个系数。所以裁剪 不改变梯度的方向,只改长度:不是「削掉个别大梯度」,而是全体等比 缩小,形状不变。用一组数值直接反推:某层梯度从 0.0411 缩到 0.0185, 缩放因子 0.0185/0.0411 = 0.45 → 总范数 = 1.0/0.45 ≈ 2.22,即该步 全局梯度范数超阈值,被整体缩到 45%;
-
返回值是裁剪前的总范数——正好打进训练日志做观测(本实现就这么用)。
两条公式。总范数——把所有参数的梯度拼成一个向量之后的长度:
超阈值就整体等比缩放(min 保证只缩不放):
「同一个系数乘遍所有梯度」的效果——每根柱子同比例缩短,形状与方向不变:
调用位置也有约束:必须放在 backward() 之后、step() 之前。早了梯度还没算出来;晚了更新已经带着爆炸梯度发生。
最后是适用边界:裁剪只控制「步子多大」,不控制「往哪走」。如果梯度方向本身是错的(第 5 章小数据上过拟合就是例子),裁剪会忠实地缩小错误方向的步长。它治梯度爆炸,不治方向错误。一个可对照的事实:GPT-3 论文的训练配置里就有 "clip the global norm of the gradient at 1.0"。本章的 max_norm=1.0 是论文同款。
8.4 LibTorch 的手动学习率调度
从 Python 迁到 LibTorch,先要接受一个事实:torch.optim.lr_scheduler 不存在。改学习率没有 scheduler.step(),做法是每步把算好的 lr 写回 param_groups()。optimizer.step() 不会自动调 lr,zero_grad() 也不会清理上一步的 lr——调度责任全部在训练循环里。
写法不复杂:在 train_model_simple 的骨架上插入三处(include/training_D.h):
// 优化器超参也升级:GPT-2 论文同款 betas
torch::optim::AdamW optimizer(parameters,
    torch::optim::AdamWOptions(lr_max).betas({0.9, 0.95}).weight_decay(0.1));

for (size_t i = 0; i < train_loader.size(); ++i) {
    // 1) 每步重算学习率并写回所有 param_group
    double lr = get_lr(global_step, warmup_steps, max_steps, lr_min, lr_max);
    for (auto& g : optimizer.param_groups()) {
        static_cast<torch::optim::AdamWOptions&>(g.options()).lr(lr);
    }

    optimizer.zero_grad();
    auto loss = ch5::calc_loss_batch(batch.inputs, batch.targets, model);
    loss.backward();

    // 2) 裁剪(在 backward 之后、step 之前)
    double norm = clip_gradients(parameters, max_norm);

    optimizer.step();

    // 3) 观测:lr、grad_norm 与 loss 一起打印
    if (global_step % eval_freq == 0) {
        std::cout << "Ep " << (epoch + 1) << " | step " << global_step
                  << " | lr " << lr << " | grad_norm " << norm
                  << " | train_loss " << tl << " | val_loss " << vl << "\n";
    }
}|
LibTorch 的学习率调度是手动的:没有 Python 侧 |
踩坑案例:被默认值覆盖的 peak_lr
|
一个真实的 Python 案例:一份广为流传的训练参考实现里,
我们的 C++ 版本显式写
|
这类错误不报错、不崩溃:训练照跑,loss 照降,问题出在下游。所有依赖这条曲线的结论悄悄作废——调参对照全部失真,复现者拿文档默认超参怎么都凑不出原曲线。静默错误比崩溃更难排查,难在它不会宣告自己的存在。教训一句话:调度器的峰值 lr 必须来自唯一的配置源。要么全部读自优化器参数组,要么全部读自一份配置,不能两处来源各说各话。
8.5 消融实验:验证梯度裁剪的作用
判断保险是否有效,标准做法是拆掉它再训一次。src/main.cpp 的做法:用 copy_ 把同一组初始参数复制给两个模型,同 seed、同数据、同 lr 调度。两组唯一的区别是:对照组 backward() 之后不做 clip_gradients,直接 step()。同起点是归因的前提——起点不同,差异就不能归因给被拆掉的部件。
// 复制初始参数,保证对照实验起点完全一致
auto src_params = model->parameters();
auto dst_params = model_no_clip->parameters();
for (size_t i = 0; i < src_params.size(); ++i) {
    torch::NoGradGuard g;
    dst_params[i].copy_(src_params[i]);
}
// 对照循环里唯一区别:backward 之后不做 clip_gradients,直接 opt_nc.step()这就是消融实验(ablation):移除系统的某个部件,观察性能变化;变化越大的部件,作用越关键。复制参数必须包在 NoGradGuard 里:不进梯度图,纯数据搬运。
运行后重点看前几步(lr 预热段):两组起点参数相同、step 0 的 lr 又是 0,损失却不同(10.99 对 9.86)——这暴露的是评估所采批次的差异(两组的数据顺序并不相同),不是裁剪的影响。真正的观察是:演示规模的梯度范数只略高于阈值 1.0,裁剪在 7 步的演示里不会遇到需要出手的时刻,它防的是范数爆冲的尾部风险。预热的「温柔爬升」与裁剪的「安全阀」是互补的两道保险——一道挡开局大步,一道挡突发爆炸,生产配置两道都上。
对照数字的归因边界
同配置把轮数从 10 加到 15,train loss 从 0.671 降到 0.118(15 轮实测),看似是「训练更好了」。实际不能这么归因:
|
跨配置的对照数字不是受控实验:第 5 章 10 轮的 train 0.671 与同配置 15 轮实测的 train 0.118,差距全部来自轮数(每加一轮,训练词元就被多看 一遍),与三件套无关。在 4612 个训练词元被看 15 遍的小数据集上,任何 配置最终都会过拟合。 这三个技术的价值要到大规模、单轮、数据不重复的真实预训练场景才能 体现。它们解决的是「训练稳定性」,不是「小数据过拟合」。 |
结论:对照实验一次只动一个变量,受控实验还要封死其余所有变量。copy_ 保证同一起点,剩下的差异才可归因。把性能变化归功或归咎于某个技术之前,先数一数同时改动了几个变量。
8.6 过拟合诊断:读懂 train/val 曲线
train 和 val 两条曲线分叉时,先不要改代码——这一节的工具不是代码,是读数能力。GPT-2 124M 在 The Verdict(train 4612 词元 / val 534 词元,9 个训练批次)上训练 15 epoch(共 135 步)的实测曲线(./scripts/run.sh chapter05_pretraining 15,RTX 4080):
Step | Epoch | Train loss | Val loss
   0 |     1 |      9.717 |   10.024    ← 起点:双双 ≈ 地板 ln(50257)
  45 |     6 |      3.440 |    6.151    ← val 最低点附近
  75 |     9 |      1.111 |    6.290    ← val 开始反弹
 105 |    12 |      0.357 |    6.663
 130 |    15 |      0.118 |    6.841    ← train/val 差距 58 倍
三个数据点值得读:step 0 时 train/val 双双 ≈ 9.7/10.0(接近 ln(50257) ≈ 10.82 的地板,模型只会瞎猜);step 45 附近 val 触底 6.15 后开始反弹;step 130 时 train 0.118、val 6.841,差距 58 倍。
过拟合有三个诊断信号,按可靠度排序:
-
train loss ≪ val loss(差距 >10 倍即强信号);
-
val loss 先降后升——过拟合的「指纹」,V 形曲线一旦出现基本可以定论;
-
生成文本新颖度下降:遇到训练集里的 prompt 逐字复述, 遇到没见过的 prompt 胡言乱语。
排序的理由:第一条有干扰项——train 低于 val 是常态,数据分布不同也会拉开差距,单看它容易误报。val 的 V 形和「背诵现场」才是行为层面的直接证据。
规模账更能说明问题:124M 参数 ÷ 4612 个训练词元 ≈ 每个词元背后 2.7 万个参数——大模型 + 小数据 = 记忆,不是学习。本次实测 val 6.84 的反弹、第 6 章 97% 的训练集准确率,都是同一现象的不同表现。对策也已经就位:第 7 章换更大更多样的指令数据,第 9 章用 LoRA 限制可训练容量。
诊断能力有边界:能诊断不等于能治愈。读完本章,你至少能对一条分叉曲线给出判断:「这是过拟合,信号是 val 拐头」。你还能区分「现象正常、量级失控」与「现象本身异常」,而不是把正常现象当成 bug 来排查。
8.7 编译与运行:核对四段输出
# 独立构建(在代码仓库根目录执行)
cmake -S chapters/chapter08_training_loop -B chapters/chapter08_training_loop/build \
      -DCMAKE_CXX_COMPILER=/usr/bin/g++-11
cmake --build chapters/chapter08_training_loop/build -j

# 运行(直接执行需自带 LibTorch 运行库路径)
export LD_LIBRARY_PATH=/opt/libtorch/lib:${LD_LIBRARY_PATH:-}
./chapters/chapter08_training_loop/build/chapter08_training_loop           # CPU,约 1-2 分钟
./chapters/chapter08_training_loop/build/chapter08_training_loop --cuda    # GPU 可用时
不需要下载 GPT-2 权重(演示用随机初始化的缩小版 GPT:emb=256、4 层、 4 头、ctx=256,语料为内置短文重复 30 次,训练只跑 1 个 epoch、7 个批次), 需要 BPE 文件(第 0 章已备)。输出分四段,每段对应 本章一个知识点——调度表、训练观测、消融对照、曲线汇总。运行后逐段核对:
=== D.1 + D.2: learning-rate schedule ===
step   lr
0  5e-05
5  0.0003
9  0.0005
20  0.00025          ← 与手算表逐值对照
30  1e-06

=== D.4: training with the new schedule ===
Ep 1 | step 0 | lr 0 | grad_norm 1.67618 | train_loss 10.9948 | val_loss 10.9953
Ep 1 | step 5 | lr 0.00025 | grad_norm 1.70978 | train_loss 10.1643 | val_loss 10.1683
                      ↑ 起步偏移:打印的 lr 对应 get_lr(步号−1)——step 0 算出 0,
                        step 5 算出 2.5e-4 而非调度表的 3e-4(8.2 边界细节);演示共 7 个批次

=== D.3 ablation: turning off gradient clipping ===
[no-clip] step 0 lr 0 train_loss 9.85638
[no-clip] step 5 lr 0.00025 train_loss 9.0626
          ↑ 对照组起步反而更快(见 8.5 的说明)

=== summary ===
losses_with_clip_first = 10.9948 10.1643   ← 两组曲线并存,对比观察
本章小结
train_model_simple 的 "simple" 省掉了三道保险:预热治开局,余弦治结局,裁剪治爆炸。三道齐备,才是 train_model。
-
调度函数
get_lr三段式全部可手算:线性预热(step+1保证第一步非 0)、余弦衰减(先慢后快滑向地板)、地板 lr_min 兜住中途加步数的意外。LibTorch 里调度是手动的,每步向param_groups()写回。 -
梯度裁剪三个语义:全局 L2 范数(拼成一个向量)、统一缩放因子(只改长度不改方向)、返回裁剪前范数供观测。位置卡在 backward 与 step 之间;
+1e-5防除零、只缩不放。 -
消融实验用
copy_保证同一起点:预热与裁剪是互补的两道保险;对照实验 ≠ 受控实验,一次只动一个变量。 -
过拟合三信号:train ≪ val 是警报,val 先降后升是指纹,生成背诵是铁证;大模型 + 小数据 = 记忆,不是学习。
-
三件套解决的是训练稳定性,不是小数据过拟合;peak_lr 死代码的教训是「调度器的峰值 lr 必须来自唯一的配置源」。
自测清单
能不回看就答出这些,本章就算过关:
-
调度表与手算一致(step 0/5/9/10/20/30 六个点)
-
能不查资料手算 step 20 的 lr(余弦中点,cos(π/2)=0 → 系数 0.5)
-
训练日志同时打印 lr 与 grad_norm(观测生效)
-
grad_norm 打印生效(演示配置实测 ≈ 1.7,与 8.1 的实测同量级)
-
对照组(无裁剪)与实验组同起点(参数复制成功)
-
能对任意 loss 曲线说出「过拟合三信号」
-
能复述 clip_grad_norm 三个语义(全局范数 / 统一缩放保方向 / 返回裁剪前值)
-
能解释
+1e-5防除零与「只缩不放」各自的必要性 -
能说出「peak_lr 死代码」教训与「对照不是受控实验」的理由
习题
-
把
warmup_steps改成 1 和 25(总步数 30 不变),观察训练前 10 步 loss 的稳定性差异——预热过短和过长各有什么代价? -
把
max_norm从 1.0 改成 0.1 和 10.0,记录 grad_norm 打印值的变化; 0.1 时训练明显变慢了吗?为什么? -
构造一组全零梯度调用
clip_gradients:先临时去掉+1e-5——你会 发现什么都没发生(inf < 1.0 为假,守卫挡住了 inf);再把if (clip_factor < 1.0)守卫也去掉,NaN 才会经 inf×0 进入梯度。 两道防线各挡什么,一试便知。 -
给
train_model增加「val loss 连续 3 次评估不下降就提前停止」的逻辑, 用第 5 章的 10 epoch 预训练验证它能省多少步。 -
把余弦衰减换成线性衰减(一行改动),对比 30 步内的 loss 曲线—— 差异大吗?什么时候余弦的优势才显现?
-
(思考)AdamW 的
betas({0.9, 0.95})与默认0.9, 0.999的区别: 为什么 GPT-2 论文把二阶动量的衰减调快? -
(思考)把三件套搬到第 9 章的 LoRA 微调场景:可训练容量变小后, 过拟合三信号会怎么变?哪些信号还成立?
拓展阅读
-
Brown et al., 2020, Language Models are Few-Shot Learners(GPT-3,预热 + 余弦调度 + 全局梯度范数裁剪 1.0 的出处): https://arxiv.org/abs/2005.14165
-
PyTorch
clip_grad_norm_官方文档(三个语义的原文出处): https://pytorch.org/docs/stable/generated/torch.nn.utils.clip_grad_norm_.html -
Vaswani et al., 2017, Attention Is All You Need(原版 Transformer,warmup 机制的早期出处): https://arxiv.org/abs/1706.03762
-
Loshchilov & Hutter, 2017, SGDR: Stochastic Gradient Descent With Warm Restarts(余弦退火原始论文): https://arxiv.org/abs/1608.03983
-
Loshchilov & Hutter, 2019, Decoupled Weight Decay Regularization(AdamW 原始论文): https://arxiv.org/abs/1711.05101
-
PyTorch AdamW 文档(默认
lr=1e-3,peak_lr 死代码案例的关键事实): https://pytorch.org/docs/stable/generated/torch.optim.AdamW.html -
LibTorch C++ API(param_groups 手动管理): https://pytorch.org/cppdocs/
-
消融实验方法论:Meyes et al., 2019, Ablation Studies in Artificial Neural Networks: https://arxiv.org/abs/1901.08634
-
torch.Tensor.copy_文档: https://pytorch.org/docs/stable/generated/torch.Tensor.copy_.html -
过拟合与欠拟合可视化对照(scikit-learn 官方文档): https://scikit-learn.org/stable/auto_examples/model_selection/plot_underfitting_overfitting.html
-
GPT-2 官方模型卡: https://huggingface.co/openai-community/gpt2
-
上一章回看:第 5 章 预训练 的
train_model_simple是本章的改写基础