第 2 章 文本 → 词元 → 向量
|
本章导读:把一段原始文本加工成能直接输入注意力模块的张量。 学完本章你将能够:
产出与代码: |
2.1 LLM 只处理数字
大语言模型不认识文字。
神经网络只对数字张量做运算,无法对字符串求梯度——就像无法对「你好」两个字做乘法。文本必须先变成数字,训练和推理才有出发点。
所以在谈注意力、谈训练之前,得先解决一个基础问题:怎么把文字变成数字,而且是携带语义信息的数字。这道工序叫嵌入(embedding):把离散对象(单词、图像,甚至整个文档)映射到连续向量空间中的点。
这串数字不能随意指定。语义相近的词,向量距离也近:「猫」和「狗」在空间中彼此接近,「猫」和「微分方程」相距很远。距离与方向都携带语义,后续的数学运算才有意义。
维度指的是向量的长度。维度越高,能表达的语义细节越多,计算开销也越大——这是性能与效率的典型权衡。参考规模:GPT-2 最小版用 768 维,GPT-3 用 12288 维。嵌入不限于词——句子、文档都有对应方案(RAG 检索使用的就是文档嵌入),但类 GPT 模型逐词生成,本教程只关心词嵌入。
word2vec 与 LLM 嵌入的区别
提到词嵌入,绕不开 word2vec——2013 年 Google 的 Mikolov 团队提出的模型。它的核心思想,一句话就能说清:经常出现在相似上下文里的词,语义大概率相似。
这个思路是正确的,但 LLM 的嵌入和 word2vec 的嵌入在机制上有三条本质区别:
| word2vec | 大语言模型 | |
|---|---|---|
嵌入来源 |
独立模型专门训练后产出,供人使用 |
模型自己的第一层,随模型一同训练 |
是否随训练更新 |
否——训练完成后固定 |
是——可训练参数,反向传播每步都会更新 |
认不认上下文 |
「苹果」在水果和手机语境里是同一个向量 |
进入注意力后结合上下文,同一个词在不同句子中有不同的表示 |
概括来说:word2vec 是先训练好词向量再使用,LLM 的嵌入矩阵本身就是模型参数、随训练更新。这条区别会在 2.6 节落到代码——届时会看到嵌入权重如何随机初始化、如何参与训练。

2.2 分词粒度的选择
嵌入解决了「词变数字」,但跳过了一步:变成数字之前,先要把文本切分成词元。切分粒度直接决定模型的能力上限——切得太粗,遇到未登录词就无法处理;切得太细,序列过长,计算代价高。三种粒度对比如下:
| 粒度 | 例:"The quick brown fox" | 代价 |
|---|---|---|
字符级 |
|
序列极长,模型需要更多计算步数才能学到「词」 |
单词级 |
|
词表规模失控;遇到未登录词即失败(OOV) |
子词级(BPE) |
常见词保留整词,生僻词拆成小块 |
两者折中——GPT-2 的选择,词表固定 50257 |
结论是明确的:现代 LLM 均采用子词级分词。字符级主要用于教学演示,单词级问题过多,子词级是工业界的通用方案。
分词也不是可以忽略的预处理:它划定模型的能力边界,而主流 API 按词元计费,切分方式直接决定成本。
要理解 BPE 的价值,最直接的办法是先实现「没有 BPE」的版本,观察它的问题。下一节就这么做。
2.3 朴素分词器及其局限
朴素分词器不含任何分词算法,只靠正则表达式切词。它实现简单,但遇到词表外的词就会失败。
正则切词:四步迭代
分词正则很难一次写对,实践中需要逐步迭代,每一步解决前一步的一个具体问题:
| 步 | 正则 | 遗留问题 |
|---|---|---|
① |
|
标点仍与单词相连( |
② |
|
列表里混入空白字符项和空串 |
③ |
过滤 |
干净了,但只认逗号和句号 |
④ |
|
✅ 最终版 |
最终效果(也是 C++ 实现的验收样例):
"Hello, world. Is this-- a test?"
→ ['Hello', ',', 'world', '.', 'Is', 'this', '--', 'a', 'test', '?']
C++ 用 std::sregex_iterator 等价实现 Python 的 re.split,定义在 include/simple_tokenizer.h:
// Python re.split("(pattern)", text) 的等价:分隔符之间的文本和分隔符本身都保留
inline std::vector<std::string> re_split_capture(const std::string& text,
                                                 const std::string& pattern) {
    std::vector<std::string> parts;
    std::regex re(pattern);
    std::sregex_iterator it(text.begin(), text.end(), re), end;
    size_t pos = 0;
    for (; it != end; ++it) {
        const std::smatch& m = *it;
        parts.push_back(text.substr(pos, m.position() - pos));  // 分隔符前
        parts.push_back(m.str(0));                              // 分隔符本身
        pos = m.position() + m.length();
    }
    parts.push_back(text.substr(pos));  // 尾部
    return parts;
}

// 分割后过滤空串与纯空白:[t.strip() for t in result if t.strip()]
inline std::vector<std::string> split_tokens(const std::string& text,
const std::string& pattern);|
这里有两个设计取舍:不要把文本统一转小写——保留大写有助于模型区分专有名词、理解句子结构;空白字符单独编码还是移除?移除省内存省计算,但会丢掉缩进信息——Python 代码缩进即语法,处理代码类文本不能这么干。本教程语料是小说,没有这个顾虑,暂时移除以简化输出,BPE 方案会以 |
词汇表的构建
分词产出的是字符串,模型需要数字,因此还要构建词汇表(vocabulary),流程固定:
std::set<std::string> unique(all_words.begin(), all_words.end());  // 排序+去重
// 1130 个唯一词元,enumerate 编号 → vocab('!'=0, '"'=1, ... 'Her'=49, 'Hermia'=50)
对 The Verdict 全文分词得到 4690 个词元;去重后有 1130 个唯一词元,逐个编号。语料是一篇 20,479 字符的短篇小说,位于 data/the-verdict.txt。SimpleTokenizerV1 负责 encode/decode:
class SimpleTokenizerV1 {
public:
    explicit SimpleTokenizerV1(const std::unordered_map<std::string, int>& vocab);
    std::vector<int> encode(const std::string& text) const;  // 分词 → 查表 → ID
    std::string decode(const std::vector<int>& ids) const;   // 反查 → 拼接 → 去标点前空格
private:
    std::unordered_map<std::string, int> str_to_int_;
    std::unordered_map<int, std::string> int_to_str_;        // 逆向词汇表
};
特殊词元与失败示例
还剩两个问题:词表中没有的词怎么处理?两段独立文本拼接时,边界如何标记?标准做法是引入特殊词元:未知词统一替换为 <|unk|>,文本边界用 <|endoftext|> 标记——预训练用它拼接多个文档,模型由此知道两段文本虽相连但内容无关。SimpleTokenizerV2 加入这两个词元后,词表规模从 1130 增加到 1132:
text = "Hello, do you like tea? <|endoftext|> In the sunlit terraces of the palace."
[V2] encode(text) = [1131, 5, 355, 1126, 628, 975, 10, 1130, 55, 988, ...]
                       ^Hello 被替换成 <|unk|>          ^<|endoftext|> 完整保留
[V2] unk_id = 1131, eot_id = 1130
更完整的特殊词元家族还包括 [BOS](序列开始)、[EOS](序列结束)、[PAD](填充)。GPT-2 的实际做法是三项都不使用:
-
不用
<|unk|>——BPE 把生僻词拆成子词,从源头避免未登录词(见 2.4); -
不用
[BOS]/[PAD]——一个<|endoftext|>兼任结束符和填充符(HF 官方 GPT-2 分词器配置里,unk/bos/eos 三个字段全部指向它——一个词元承担三种职责); -
填充位不计损失——批量训练时,填充位置用掩码让模型不关注(第 7 章的
-100掩码会落实这个机制)。
最后看失败示例:V1 对 "Hello, do you like tea?" 直接抛异常——"Hello" 在这篇小说里从未出现,词表中查不到。一部短篇小说构建的词表,处理不了一句日常问候。这是小语料加词级切分的主要缺陷,也是引入 BPE 的直接动机。
2.4 字节对编码(BPE)
BPE(Byte Pair Encoding,字节对编码)的解法很直接:词表里没有的词,拆成词表里有的子词。 任何生僻词、自造词、错别字,最终都能拆成子词甚至单个字符——模型总能查到,未登录词问题从根源上解决。
BPE 的起源
BPE 最初并不是为 NLP 设计的。它 1994 年问世时的本职是数据压缩——把文本中反复出现的字节对换成一个新符号,文本随之变短。2016 年 Sennrich 等人把它引入神经机器翻译来处理生词问题,随后 GPT-2 将它用作官方分词器,自此成为行业标准。
BPE 的核心循环分三步:
① 把所有单个字符(a、b、…)加入词汇表
② 扫一遍语料,找出最常一起出现的相邻字符对,合并成一个新 token
③ 重复②——把刚合并出的 token 继续参与下一轮合并,直到凑够预算
高频组合逐步合并成新词元,低频组合保持零散:常见词最终合并成整词,生僻词停在较小的子词。这就是 BPE 的全部原理。
GPT-2 词表:50257 的构成
GPT-2 词表的规模由三个数字相加得到:
256 + 50000 + 1 = 50257
-
256:全部字节。这是基础——任何语言、任何 emoji 本质上都是字节流,256 个字节保证任何输入都能表示;
-
50000:合并规则产出的词元数量;
-
1:特殊词元
<|endoftext|>,ID 为 50256,是全词表中最大的 ID。
配套数据是两份文件(位于 data/,由 scripts/download-data.sh 下载),二者完全定义了这个分词器:
| 文件 | 内容 |
|---|---|
|
token → id 映射(等价 HF |
|
合并规则,每行 |
Ġ:字节到可打印字符的映射
打开词表文件,会看到大量 Ġ 开头的词元,例如 Ġworld。这不是乱码,而是编码设计的结果。
GPT-2 的 token 基于字节,但字节里有不少不可打印字符(空格、换行),直接存词表无法阅读。于是有一个 bytes_to_unicode 映射步骤,把不可打印字节搬进「可打印字符」的安全区——空格映射为 Ġ。这个设计的实际效果是:空格保留在 token 内部,Ġworld(带前导空格)和 world(不带)是两个不同的词元。回到 2.3 节「要不要移除空白」的问题,答案在这里:BPE 用 Ġ 完整保留了空格信息。
Python 生态使用 tiktoken(OpenAI 官方实现,基于 Rust,速度快);本教程的 C++ 版从零实现,核心流程分五步:
// 流程:文本 UTF-8 -> bytes -> bytes_to_unicode 映射为可打印字符
//       -> 正则切分成"单词"(含前导空格) -> 单词内贪心 merge -> 查表得 token id
class BpeTokenizer {
public:
    BpeTokenizer(const std::string& encoder_json_path, const std::string& vocab_bpe_path);
    std::vector<int> encode(const std::string& text,
                            const std::vector<std::string>& allowed_special = {}) const;
    std::string decode(const std::vector<int>& ids) const;
    size_t vocab_size() const { return encoder_.size(); }
    int token_id(const std::string& token) const;   // 不存在返回 -1
private:
    std::unordered_map<std::string, int> encoder_;               // token -> id
    std::map<std::pair<std::string, std::string>, int> merges_;  // (a,b) -> rank
    std::array<std::string, 256> byte_to_char_;                  // 字节 → 可打印字符
    ...
};|
一个常见的坑:编码 |
交叉验证与确定性输出
如何证明手写版实现正确?仓库接入了 torchtext 官方的 GPT2BPEEncoder(include/torchtext_gpt2_bpe.h + third_party/torchtext/,依赖 libre2-dev)。main.cpp 取一段不含特殊词元的文本,对手写版与官方版做逐 ID 对比,结果完全一致。这是实现正确性的直接证据。
./scripts/run.sh chapter02_text_data词汇表大小 vocab_size = 50257
token_id('<|endoftext|>') = 50256 token_id('Hello') = 15496
encode("Hello, do you like tea? <|endoftext|> In the sunlit terraces
of someunknownPlace.")
= [15496, 11, 466, 345, 588, 8887, 30, 220, 50256, 554, 262, 4252, ...]
decode(integers) = "Hello, do you like tea? In the sunlit terraces of someunknownPlace."输出里有两个细节:someunknownPlace 这样的未登录词没有变成 <|unk|>,而是被拆成 some/unknown/Place 三个子词——子词拆分保证任何词都能编码;220 是孤立的空格词元(Ġ),紧挨在 <|endoftext|> 之前。
|
同一份语料,两种分词,两个数字:正则简易分词 4690 个词元(词表 1130),BPE 5145 个词元(词表 50257)。BPE 会拆分子词,词元数更多,换来的是词表固定、无未登录词。 |
2.5 滑动窗口生成训练标签
第 1 章提到,LLM 预训练是自监督任务,不需要人工标注。这一节说明标签是如何自动生成的。
手法只有一句话:把输入右移一位,就是标签。
语料 A B C D E,取 A B C 做输入,那么 B C D 就是标签——每个位置上,模型要预测的「下一个词」就在原文里。标签直接取自语料本身,无需任何人工标注。
具体实现是滑动窗口:在词元序列上开一个长 max_length 的窗口,窗口内的 L 个词元做输入,右移一位的 L 个做目标;然后窗口向前滑动 stride 位,再切一份。src/main.cpp 里的 GPTDataLoader 把「数据集切分 + 批组装」合在一个类里(等价 PyTorch 生态的 Dataset + DataLoader 组合):
// 对应 GPTDatasetV1: for i in range(0, len - max_length, stride)
for (int i = 0; i + max_length < (int)token_ids.size(); i += stride) {
    input_rows_.push_back({ids.begin() + i,          ids.begin() + i + max_length});
    target_rows_.push_back({ids.begin() + i + 1,     ids.begin() + i + max_length + 1});
}
// drop_last: 不足一个 batch 的尾部丢弃;shuffle: 按 seed 打乱样本顺序
实测(先跳过前 50 个词元,max_length=4):
BPE 分词后词元总数 len(enc_text) = 5145   ← 编码后跳过前 50 个词元

x = [290, 4920, 2241, 287]
y =       [4920, 2241, 287, 257]        ← y 就是 x 右移一位

-- 下一单词预测任务(文本形式)--
  and                        ---->  established
  and established            ---->  himself
  and established himself    ---->  in
  and established himself in ---->  a

-- DataLoader(batch_size=1, max_length=4, stride=1) --
first_batch inputs  = [[290, 4920, 2241, 287]]
first_batch targets = [[4920, 2241, 287, 257]]
second_batch inputs = [[4920, 2241, 287, 257]] ← 与 first_batch 左移一位第二批相对第一批整体左移一位——这就是「滑动」的含义。四个超参各控制一件事,各自的权衡如下:
| 超参 | 含义 | 权衡 |
|---|---|---|
|
批次间输入的位移量 |
|
|
每个输入块的词元数 |
本教程演示用 4,实际训练通常不小于 256 |
|
丢弃不足 batch_size 的最后一批 |
真实目的是防止训练期间损失剧增——最后一批如果特别小,这一批的损失会异常大,影响整轮平均值 |
|
每批样本数 |
小批次省内存但更新噪声大;大批次稳定,吃显存 |
|
调试数据流水线时的实操建议:先打印几个 batch 肉眼检查—— |
2.6 词元嵌入:可训练的查表层
「嵌入」配上「向量空间」「语义表示」等术语,显得抽象。拆开看,实现很朴素:一张权重矩阵,加一次查表操作。
训练开始前,这张表必须用随机值初始化——这是学习的起点:
const int vocab_size = 50257, output_dim = 256, max_length = 4;
auto token_embedding_layer = torch::nn::Embedding(vocab_size, output_dim);
auto pos_embedding_layer   = torch::nn::Embedding(max_length, output_dim);
权重矩阵形状 = vocab_size 行 × output_dim 列:每行对应词表中一个词元。对 ID=3 做前向计算,得到的向量与权重矩阵第 4 行完全相同——
|
嵌入层本质是一次查表操作,不是矩阵乘法:根据词元 ID 从权重矩阵中检索出相应的行。但它又可以视为更高效的独热编码实现——把词元 ID 转成独热向量再乘这张矩阵,效果恰好等于「挑出对应那一行」(其他位的 0 把其余行全部消去)。数学上一模一样,工程上不存那些 0、不算那些乘法。正因为它等价于一个网络层,它才是可训练的——反向传播能顺着这条等价关系更新这张表。这是它和「拿现成 word2vec 向量」的根本区别:这张表是模型的一部分,随训练一起更新。模型的「语义理解」起点是一张随机数的表;语义来自训练过程,而不是初始化。 |
再算一笔参数账:这张表 50257 × 768 ≈ 3860 万个参数,是 GPT-2 全模型中最大的单项之一——但前向计算时它只做检索、不做乘法。统计参数量时不要遗漏它。
2.7 位置嵌入
词元嵌入就位后,还缺一块关键拼图——没有它,模型无法区分「狗咬人」和「人咬狗」。
问题出在自注意力机制本身:它不感知位置。原因藏在查表机制里:同一个词元 ID,无论出现在句首还是句尾,查出的向量完全相同;注意力计算又只依据向量内容打分——「狗咬人」里「狗」的向量和「人咬狗」里「狗」的向量相同,注意力给出的分数也相同。对注意力来说,这两句话不可区分。
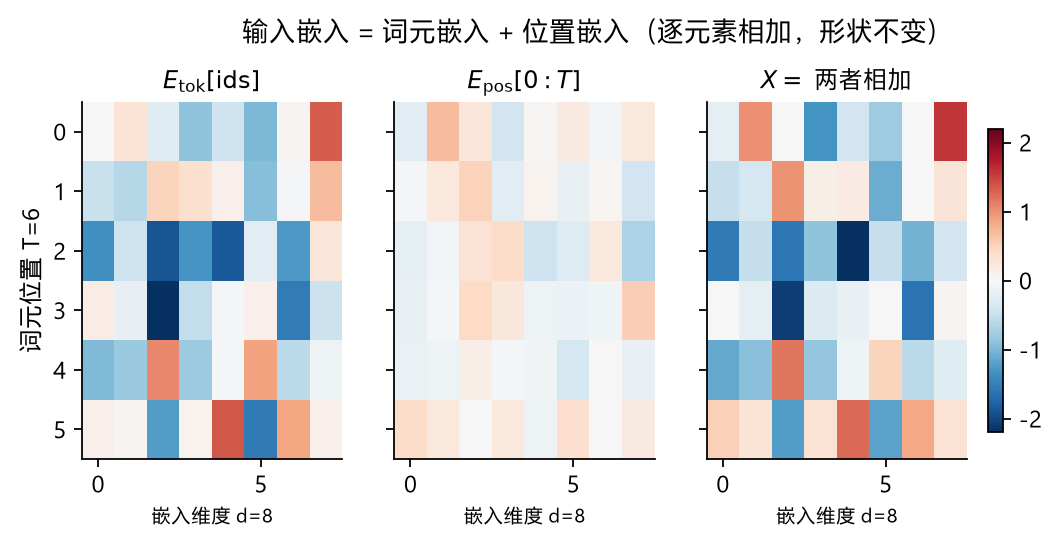
词序信息就此丢失,而语言恰恰依赖顺序表意。补救方法很直接:给位置单独做一套嵌入,「词是什么」和「词在哪」两套信息逐元素相加:
| 策略 | 做法 | 特点 |
|---|---|---|
绝对位置嵌入 |
与序列中的特定位置绑定:第 1 个词元有特定嵌入,第 2 个有另一个 |
简单直接 |
相对位置嵌入 |
关注词元之间的相对位置或距离,学的是「距离」关系 |
能更好地泛化到训练中从未见过的长度 |
OpenAI 的 GPT 系列采用可学习的绝对位置嵌入;原始 Transformer 用的则是不可训练的正弦函数编码(形式类似信号处理中的波形)。实现上它就是又一张查询表:max_length(位置数)× output_dim。GPT-2 上下文最长 1024 个词元,这张表就是 1024 × 768。
为什么放弃正弦函数、改用可学习的查表?正弦编码不占参数,理论上可外推到
训练中没见过的长度,但每个位置的向量是公式写死的。可学习的版本反过来:
模型自己学出每个位置的表示,实现与词元嵌入同构,代价是位置数锁死在
max_length,超长只能截断。GPT-2 发布时(2019 年)相对位置方案
已有探索但尚未成熟,可学习的绝对位置是当时工程上最直接的选择。几年后
旋转位置编码(RoPE)普及,新模型才普遍转向。
auto token_embeddings = token_embedding_layer->forward(inputs);   // [8, 4, 256]
auto pos_embeddings   = pos_embedding_layer->forward(
                            torch::arange(max_length, torch::kLong)); // [4, 256]
auto input_embeddings = token_embeddings + pos_embeddings;   // 广播相加 → [8, 4, 256]
写成公式——两类嵌入逐元素相加,形状不变(广播把 [4, 256] 复制到批次内每个样本上):

相加的结果中,词元嵌入承载「这个词是什么」,位置嵌入注入「它在第几个位置」,X 同时带着两种信息进入第 3 章的注意力:
|
两个容易写错的细节:① |
2.8 全章形状变化总览
从字符串到「能喂进注意力」的张量,每一步的形状都在这张表里,调试数据流水线时对着它逐行核对:
| 阶段 | 数据形态 | 具体数值 |
|---|---|---|
① 原始文本 |
字符串 |
The Verdict,20,479 字符 |
② 分词 |
词元列表 |
简易正则 4690 / BPE 5145 |
③ 词元 ID |
整数序列 |
词表 1130(+2 = 1132)或 BPE 50,257 |
④ 批次采样 |
张量 x, y |
|
⑤ 词元嵌入 |
张量 |
|
⑥ 位置嵌入 |
张量 |
|
⑦ 输入嵌入 |
张量 |
|
通用公式:input_embeddings.shape = [batch_size, num_tokens, output_dim]。
本章产出的 [batch, token, dim] 张量,就是第 3 章自注意力机制的直接输入。
2.9 编译运行与预期输出
./scripts/run.sh chapter02_text_data输出按小节顺序分节打印(2.3 → 2.4 → 2.5 → 2.6 → 2.8;编号为程序内的演示序号,与本章小节号略有错位)。需要预先跑过 ./scripts/download-data.sh(data/ 下有 the-verdict.txt、encoder.json、vocab.bpe)。核对以下确定性输出:
Total number of character: 20479
词元数量 len(preprocessed) = 4690        ← 朴素分词
词汇表大小 vocab_size = 1130             ← V1
更新后的词汇表大小 = 1132                ← V2(+<|endoftext|> +<|unk|>)
2.5: vocab_size = 50257;  encode = [15496, 11, 466, ...]
2.6: len(enc_text) = 5145;  x = [290, 4920, 2241, 287]
2.8: input_embeddings.shape = [8, 4, 256]
与手写版交叉验证 ...  结果一致: yes
本章小结
-
大语言模型只处理数字:神经网络只对数字张量运算,嵌入负责把词变成有语义的向量;它与 word2vec 的本质区别在于嵌入层是模型的一部分、随训练更新、能结合上下文。
-
分词三粒度:字符级序列过长、单词级词表失控且有未登录词问题、子词级是工业方案——切分方式划定模型能力边界,也是 API 成本的计价单位。
-
朴素分词器(正则 + 查表 + 特殊词元)遇到未登录词即失败;BPE 用「字节全覆盖 + 高频合并」把生词拆成子词,50257 = 256 字节 + 50000 合并 + 1 特殊词元。
-
滑动窗口把自监督落到代码:标签 = 输入右移一位,无需人工标注;stride / max_length / drop_last / batch_size 四个超参各有权衡。
-
嵌入层本质是可训练矩阵的查表操作(等价于独热编码接全连接),随机初始化、随训练更新。
-
自注意力不感知位置——位置嵌入补上词序信息,使模型能区分「狗咬人」与「人咬狗」;GPT-2 用可学习的绝对位置嵌入,与词元嵌入广播相加。
自测清单
能不回看就答出这些,本章就算过关:
-
能说出 LLM 嵌入与 word2vec 的三条本质区别
-
朴素分词 4690 / 词表 1130 → 1132,与正文一致
-
BPE 词表 50257 的构成能推导:256 字节 + 50000 合并 + 1 特殊词元;
<|endoftext|>= 50256(最大 ID) -
someunknownPlace被拆成子词而非<|unk|>;能解释Ġ是什么、 为什么空格要保留在词元里 -
allowed_special不传会出什么事,能解释为什么这类错误难以排查 -
手写 BPE 与 torchtext 官方版交叉验证
结果一致: yes -
x与y相差一位;second_batch是first_batch左移一位 -
能说出 stride/max_length/drop_last/batch_size 四个超参各自的权衡
-
能解释「嵌入层是查表不是乘法」以及它与独热编码的等价关系
-
能说出注意力为什么不感知位置、GPT-2 的位置嵌入怎么补
-
input_embeddings.shape = [8, 4, 256]
习题
-
把
max_length从 4 改成 8(改src/main.cpp里demo_dataloader的context_size/max_length并重编译),观察x/y与 batch 形状的变化。 -
用
BpeTokenizer查token_id(" world")(注意前导空格是Ġ), 解释为什么带空格和不带空格的world是两个不同的词元。 -
用 BPE 对未知单词
"Akwirw ier"分词,打印所有 词元 ID,逐个decode复现子词映射,再整体decode验证还原。 -
把
max_length=2, stride=2与max_length=8, stride=2各跑一遍,观察数据加载器行为差异。 -
打开 vocab.bpe,找到对应你自己名字英文拼写的合并规则链—— 从字节到整词,经过了几次合并?
拓展阅读
-
Sennrich et al., 2016, Neural Machine Translation of Rare Words with Subword Units(BPE 进 NLP 的原始论文): https://arxiv.org/abs/1508.07909
-
Gage, 1994(BPE 前身,数据压缩算法): https://www.drdobbs.com/database/pattern-matching-the-byte-pair-encoding/184402321
-
word2vec:Mikolov et al., 2013, Efficient Estimation of Word Representations in Vector Space: https://arxiv.org/abs/1301.3781
-
OpenAI 官方分词器 tiktoken(Rust 实现): https://github.com/openai/tiktoken
-
GPT-2 论文:Language Models are Unsupervised Multitask Learners: https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
-
GPT-2 官方模型卡: https://huggingface.co/openai-community/gpt2
-
原始 Transformer(正弦位置编码出处): https://arxiv.org/abs/1706.03762