第 1 章 语言模型是什么
|
本章导读:建立大语言模型的概念框架——从只看得到前一个词的统计模型 bigram 出发,看清千亿参数模型做的仍是同一件事,最后给出 「数据 → 预训练 → 微调」的全书路线图。 学完本章你将能够:
产出与代码:概念体系 + 可运行的 bigram 预测器
( |
1.1 bigram:最简单的语言模型
现代大语言模型能写文章、写代码、回答问题。这套能力的起点,是一个简单到只看得到前一个词的模型:bigram。看懂它,就看清了所有语言模型共同的基础。
先解释术语。「语言模型」(language model)只做一件事:给定前文,预测下一个词的概率。输入半句「今天天气真」,它输出一个概率分布:「好」60%、「差」20%、「热」10%。参数上千亿的大模型,核心仍是这个预测任务。
bigram 是其中最古老的形式。bi 意为「二」,gram 意为「词」,合起来是二元语法——每次只看前一个词来预测下一个词。
它的工作方式是计数。把一批文章输入程序,统计每个词后面出现过哪些词、各多少次,再除以该词的总出现次数,得到条件概率。「天气」后面常接「好」,概率就高;常接「香蕉」,概率就低。
这个统计过程在真实代码里对应下面这段。配套 lab 把它实现为 LibTorch 程序,核心操作是把计数表按行归一化成条件概率:
torch::Tensor BigramPredictor::probability_matrix() const {
    const int64_t V = vocab_size();
    auto counts = torch::tensor(bigram_, torch::kLong)   // [V, V] 共现计数
                      .reshape({V, V}).to(torch::kFloat);
    auto row_sum = torch::tensor(unigram_, torch::kFloat)
                       .clamp_min(1.0).reshape({V, 1});  // 每行总和,防除零
    return counts / row_sum;   // 广播:P(next | current),每行归一化
}
这个模型的全部参数,就是一张 V 行 V 列的计数表。没有神经网络,没有梯度下降,不需要显卡。
编译并运行:
cd chapters/chapter01_bigram
cmake -B build -DCMAKE_PREFIX_PATH=/opt/libtorch && cmake --build build -j
LD_LIBRARY_PATH=/opt/libtorch/lib ./build/bigram_predictor_demo
LD_LIBRARY_PATH=/opt/libtorch/lib ./build/bigram_predictor_demo --seed 7 --temperature 0.7   # 固定种子 + 带温度采样
[vocab] = 11
[the ->] the(0.333) cat(0.222) mat(0.222) dog(0.111) rug(0.111)
[greedy ] the the the the the the the the ← 贪心解码陷入重复
[sample] the the the cat sat on the dog ran to the cat输出第三行 the the the the the the the the:这就是它生成文本的典型样子。
这不是程序缺陷,而是模型结构的必然结果。bigram 有一条硬性限制:预测下一个词时,只允许看前一个词。这叫马尔可夫假设(Markov assumption)。前文铺垫了三十个词,轮到它预测时,前二十九个词的信息全部丢弃。所以它无法依据上文判断该接「mat」还是「rug」:the 后面各种词都出现过,概率分散在多个词上。
陷入重复的原因也在结构里。贪心解码每步取概率最大的词,每个词因此都有唯一确定的去向。词表只有 11 个词,沿这条路线走,至多 11 步就会绕回某个走过的词,从此原地打转——塌缩不是运气差,是数学必然。这份语料刻意安排了多处「the the」共现——真实文本里,the 后面极少接 the。如此一来,the 的最大概率后继就是 the 自己;每一步都选 the,8 连 the 由此而来。循环还有另一种形态:假如 cat 和 sat 互为对方的最高概率后继,输出就会变成 cat sat cat sat 的两词旋转——机制相同,只是从原地踏步换成了来回摇摆。
温度参数能改变行为:调低,采样趋近贪心;调高,输出更随机。还有一层:「每步取最大」听起来最稳,实际却常输给带随机性的采样——研究者统计过,人写的文本里,下一个词恰好是模型最高概率词的情况占少数。但无论贪心还是采样,都治不了病根:病根是只能看到一个词的视野。解码方式再怎么换,也利用不上上下文。
带着这个印象往下读:后续章节的每一项改进,都在扩大模型能看到的上下文。
|
一个常见误区是「模型理解了语言」。在预测下一个词这个层面,能确认的事实是概率预测:预测得越来越准,生成的文本越来越像人写。「生成得像」与「理解了」是两个命题,前者的证据推不出后者。 |
|
香农的先例:bigram 这类 n 元统计模型并非只是教学用例——1948 年香农在信息论开山论文里用它生成过英文文本;后来的输入法联想、早期语音识别也属于同一思路家族。经典教材的演示更有画面感:在莎士比亚全集上训练 bigram,采样出的句子形如「What means, sir. I confess she?」——相邻两词搭得上,整句不知所云。大模型做的事,七十多年前已有雏形。 |
1.2 概念坐标系:AI ⊃ ML ⊃ DL ⊃ LLM
这四个词经常混用,但不是并列关系,而是包含关系。从大到小:AI ⊃ 机器学习 ⊃ 深度学习 ⊃ LLM。
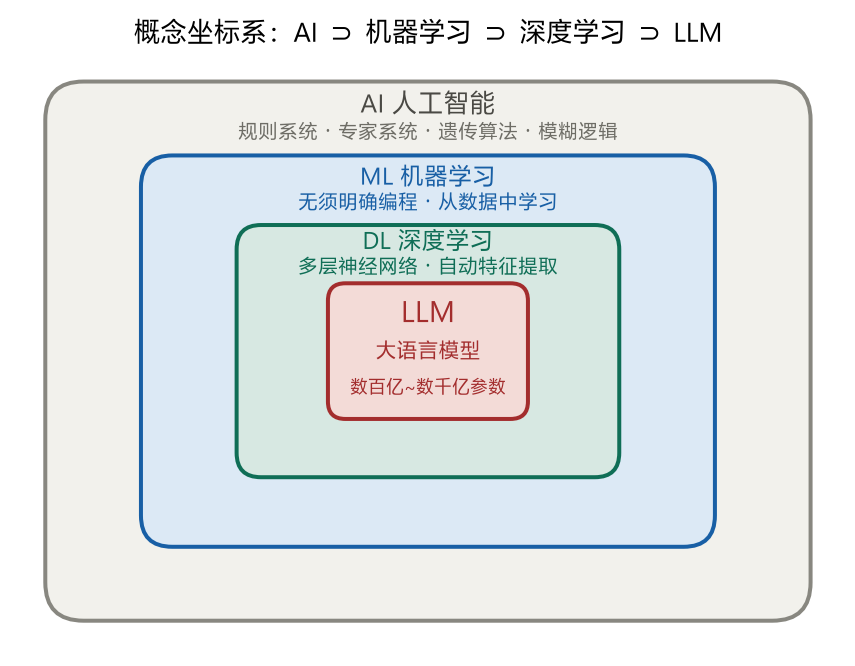
最外层的 AI 是一个总称,1956 年在达特茅斯会议上提出。它指「让机器完成需要智能的任务」,不限定具体技术——写死规则的专家系统、下棋的搜索算法,都属于 AI。
机器学习收窄一层:不把规则写死,让机器从数据中自己找规律。深度学习再收窄:用多层神经网络,特征由网络自动学习。LLM 是最内层:基于 Transformer、参数量数百亿起步的文本模型。
那么,经典机器学习与深度学习的分界线在哪里?
不在「用不用神经网络」,而在一句话:特征由谁构造。仍以贯穿全书的垃圾邮件分类为例:经典机器学习依赖人工设计特征——「中奖」出现几次、感叹号几个、可疑链接几个,模型只负责组合这些特征;深度学习直接输入原始文本,特征由网络自己学出来。这条分界线也改变了行业分工:深度学习普及后,特征工程的工作量大幅下降。
|
两个容易混淆的点: . 无论经典机器学习还是深度学习,垃圾邮件分类器都需要人工标注「垃圾/正常」标签。真正不需要标注的是预训练阶段,见 1.6 节; . 早期 NLP 模型为特定任务定制,做不到「根据关键词写一封邮件」。现代 LLM 是通用模型,一个模型覆盖所有文本任务。 |
这套层级关系的一个实际用途是核对宣传口径:看到产品自称 AI 时,先确认它指的是哪一层。某音箱自称 AI,技术上成立——AI 是总称;若其内部只是一段写死的语音规则,它就与机器学习没有关系。
1.3 核心任务:下一词预测与自回归
ChatGPT 这类模型的核心任务,与文字接龙在形式上是同一种任务:给定前文,预测下一个词。这不是比喻——预测下一个词就是它的训练目标。
顺带记下第二个术语:自回归(autoregressive)——把上一个输出作为下一个输入,循环往复。auto 指「自己生成自己的输入」。
两件事合起来,就是那条连乘公式。一段话的总概率,等于每个词在它前文条件下的概率连乘:
为什么预测下一个词能练出语言能力?三个原因:
-
语言有顺序:「狗咬人」和「人咬狗」用词相同,意思相反。要预测对下一个词,模型必须理解前文的结构;
-
任务自带监督信号:为了预测准确,模型必须学会语法、常识与逻辑。没有人显式教它,预测误差会迫使它把这些学起来;
-
训练数据利用率高:一份语料可以拆出成千上万个预测点——这是 1.6 节自监督学习的基础。
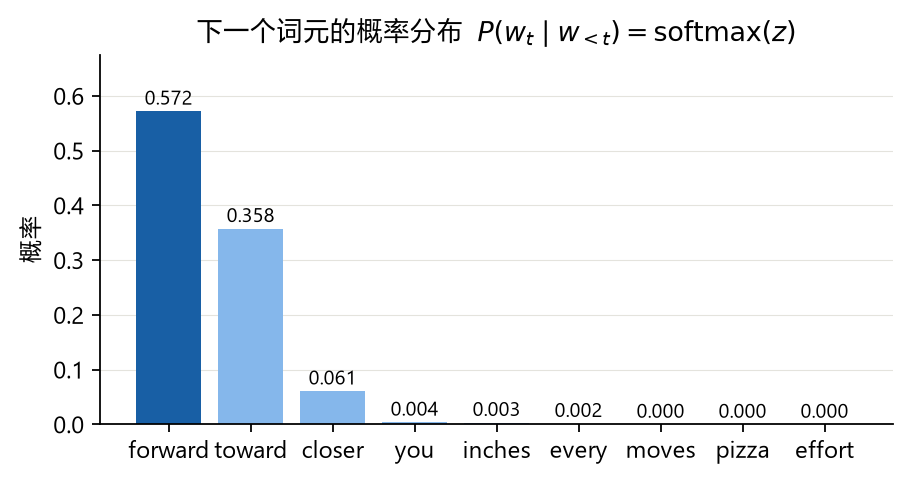
模型每一步的实际输出,是词表上每个词元(token,第 2 章详述)的概率分布 \(P(w_t \mid w_{<t})\)。下图为训练前的形态;第 5 章训练完成后会再画一张,对比可以直观看到训练改变了什么:
|
生成时模型逐词输出:每生成一个词,都要把前面所有文字重新计算一遍,得到新的分布后才输出下一个词。这解释了两个现象:生成速度随上下文变长而下降;模型可能输出不合事实的内容——每一步只是概率采样,采错了也照样输出。 |
这个任务并不新:1.1 节的 bigram 做的就是它,1948 年已有雏形。七十年来变化的是规模——视野从 1 个词元扩展到数十万词元,参数从一张计数表变为千亿级神经网络。预测准确率从三成提升到八成,靠的不是更聪明的任务设计,而是架构、算力、数据三场硬仗。
1.4 涌现:定义与争议
把模型规模做大,能换来什么?
某些能力,小模型始终学不会;规模超过某个程度后突然出现——翻译、多步算术、按指令执行任务。关键在于:这些能力未经明确训练。预训练只做一件事:预测下一个词,模型却学会了翻译——训练数据里并没有「原文—译文」的配对。
这个现象有专门的名称:涌现(emergence)——能完成未经明确训练的任务。一个类比:学生反复做口算练习,某天突然能解应用题——应用题没有单独练过,但相关能力已经组合到位。
涌现的实际意义:不同任务可以共用同一个模型,无须为每个任务单独训练。
但这个概念在学术界有争议。2023 年斯坦福的研究者发表论文质疑涌现现象,结论是:很多「涌现」可能是评测指标造成的假象。用「全对才计分」的硬指标(数学答案精确匹配,对记 1、错记 0)评测时,模型能力其实随规模缓慢线性增长。只是在阈值之前,答案一直差一点,全部计 0 分——曲线才呈现出「毫无起色—突然跃升」的形态。换成连续指标,给部分正确记部分分,同一条曲线立刻变得平滑。
换句话说:可能不是模型突然学会了,而是评分方式放大了跃变。
支持涌现存在的一方则指出:即使能力是渐变的,跨过「可用」阈值本身就有工程意义——能部署与不能部署之间确实是断崖。涌现的成因,目前没有定论。
|
面对「涌现」话题的三条建议: . 涌现是对现象的描述,不是对机制的解释——成因目前没有定论,声称已解释机制的说法超出了现有证据; . 它不影响实用判断:无论成因如何,大模型确实能完成小模型做不到的任务; . 阅读相关报道时,先确认评测指标与样本量——很多夸张的说法经不起这两个问题的检验。 |
1.5 自建模型的四大优势
调用 ChatGPT 的 API 成本很低,为什么还有公司投入数百万美元自己训练模型?
先给结论:对绝大多数应用,直接调用 API 是正确选择——没有必要每家公司都维护模型团队,就像没有必要人人都会修车。但有四类需求,API 无法满足:
| 优势 | 说明 |
|---|---|
性能 |
领域定制的模型往往在该任务上优于通用模型——通用模型在每个领域都留有余地。金融的 BloombergGPT、医学问答 LLM 都是先例 |
数据隐私 |
医疗、法律、金融等行业的数据受合规约束,不能传给第三方。自建让计算发生在数据一侧,数据不出本地环境 |
端侧部署 |
小一点的定制模型能直接跑在笔记本、手机上,延迟与服务器成本同时下降——手机输入法的离线联想就是这种方案 |
完全自主 |
API 的价格、限流、停服安排由服务商决定。自建模型的所有决策权在自己手中 |
一个有用的类比:调 API 像租房,起步快、无前期投入,但租金会涨、续约由房东决定;自建像买房,前期投入大,但资产与控制权归自己。选择依据是数据敏感度与用量规模,没有绝对的对错。
自建的真实门槛也不在训练本身,而在后半程:数据要清洗、效果要评估、版本要迭代、线上要维护。不少团队购置了硬件,最终卡在「没有干净数据」这一步。自建是一项持续的工程投入。
结论:数据敏感、领域知识重、用量大的场景适合自建;刚起步、需求不清晰、数据尚未积累的场景,先用 API 跑通业务。API 是起点,自建是按需选项。
1.6 两个阶段:预训练与微调
直接向开源基座模型提问,它可能不回答,而是继续「续写」你的问题。这不是故障:它还没有经过第二阶段的训练。
把下一词预测器改造成能理解指令的助手,需要两个阶段:
大规模无标注原始文本 ──[预训练 pre-training]──▶ 基础模型 ──[微调 fine-tuning]──▶ 任务模型
自监督学习 foundation model 小体量标注数据预训练有三个要点:
-
「预」——训练的初始阶段,使用大规模、多样化的数据;
-
「原始文本」——不包含任何标注的普通文本;
-
「自监督学习」——标签从哪里来?原文的下一个词就是标签。标签随训练数据自动生成,海量文本因此成为免费题库。这是「预训练不需要人工标注」的原因,也是它相对经典机器学习(需先人工标注数据)的成本优势。
预训练的产物称为基础模型(foundation model):掌握了语言知识,但不会按指令回应——向它提问,它倾向于续写文本。
弥补这一差距的是微调(fine-tuning):用小规模标注数据集再训练一轮,让模型学会「收到指令时如何回应」。两条经典路线,对应本教程第 6、7 章:
| 微调类型 | 标注数据集形态 | 典型例子 |
|---|---|---|
分类任务微调 |
「文本 − 类别标签」 |
已标注「垃圾邮件/非垃圾邮件」的邮件(第 6 章) |
指令微调 |
「指令 − 答案」对 |
「原文 − 正确翻译」(第 7 章) |
|
两阶段的成本相差几个量级:预训练需要数万亿词元与按百万美元计的算力。微调用一千条高质量数据、几张消费级显卡,就能显著改变模型行为。预训练构建语言能力的基础,微调在其上适配具体任务——基础模型开源后,微调是个人可以动手完成的部分。想动手微调,开源基座随处可得:
同一模型带 ChatGPT 这类产品在微调之后还有第三阶段——人类反馈强化学习(RLHF),本教程不展开;第 13 章的 GRPO 会实现一个相近的强化学习循环。 |
总结:预训练教模型预测下一个词,微调教模型理解用户指令——前者建立语言能力,后者建立任务能力。
1.7 同一架构,两类模型:Transformer 与 GPT/BERT
2017 年,谷歌发表论文《Attention Is All You Need》,提出 Transformer 架构。此后十年,它成为几乎所有大语言模型的基础。
它的初始设计目标是机器翻译。原始 Transformer 分两个模块:
-
编码器(encoder):读入一句话,编码成数值表示,捕捉上下文;
-
解码器(decoder):根据这些编码,逐词生成输出。
两个模块依赖同一个核心机制:自注意力(self-attention)——让每个词计算与其他所有词的关联强度。处理代词「它」时,模型能给前文每个词打分,确定哪些词与它相关。这取代了逐词顺序处理:每个词都能直接访问全文信息。这也是 Transformer 超越上一代 RNN 的地方——RNN 解码时无法直接访问早期隐藏状态,上下文信息逐层压缩传递,早期细节丢失严重。
同一架构,训练目标不同,得到两类模型:
| GPT 系 | BERT 系 | |
|---|---|---|
取自原始 Transformer 的 |
解码器部分 |
编码器部分 |
结构 |
仅解码器 + 因果掩码(单向) |
仅编码器,双向 |
训练目标 |
下一词预测(文本补全) |
掩码词恢复(完形填空) |
擅长 |
生成:翻译、摘要、小说、代码 |
理解:情感分析、文档分类 |
现实案例 |
ChatGPT 等 |
X(原 Twitter)用它检测有害内容 |
本教程 |
✅ 全程 GPT |
不涉及 |
两个常见的表述错误:
-
「所有 Transformer 都是 LLM」——不准确。Transformer 是通用架构,视觉领域的 ViT 用它处理图像;
-
「所有 LLM 都基于 Transformer」——不严谨。还有基于 RNN 改良与状态空间模型的 LLM,优势在推理成本。本教程中「LLM」专指类 GPT 的 Transformer 系模型。

GPT 架构相对原始 Transformer 的三个关键特征:
-
纯解码器——比原始 Transformer 更简洁,只含解码器;
-
自回归——逐词生成,把之前的输出作为未来预测的输入,保证文本连贯;
-
单向、从左到右——适合文本生成与下一词预测。
为什么生成路线最终占据主导?一个直接的原因:预测下一个词的训练数据近乎无限——任何文本都天然构成训练样本,无需标注;掩码词恢复的上限则取决于遮蔽策略的设计。在比拼规模的竞争中,自带无限训练数据的任务成为决定性优势。BERT 系在理解类任务上仍有应用,但生成类应用的主导地位由 GPT 系确立。
1.8 GPT-3:数据量级与上下文学习
2020 年 GPT-3 发布,参数量 1750 亿。公众对大模型的广泛关注,由此开始。
它最大的影响不在某个单项技能,而在零样本(zero-shot)与少样本(few-shot)能力:前者不给示例,直接描述任务;后者在提示中给出两三个示例,模型跟随示例完成任务。这类行为称为上下文学习(in-context learning):全程不更新参数,仅凭提示中的信息完成新任务。
再看数据规模。GPT-3 论文披露的预训练语料构成如下:
| 数据集 | 描述 | 词元数 | 占比 |
|---|---|---|---|
CommonCrawl(过滤后) |
网络抓取数据 |
4100 亿 |
60% |
WebText2 |
网络抓取数据 |
190 亿 |
22% |
Books1 / Books2 |
基于互联网的图书语料库 |
120 亿 / 550 亿 |
8% / 8% |
Wikipedia |
高质量文本 |
30 亿 |
3% |
各项合计:4990 亿词元。但模型实际只训练了 3000 亿。
差了近 2000 亿。论文没有解释未使用部分的原因,也没有后续勘误说明。这个细节至今没有官方答案。
词元(token)是模型读取文本的基本单位,数量大致等于文本中单词与标点的总数(第 2 章详述)。作为量级参照:仅 CommonCrawl 的 4100 亿词元就需要约 570 GB 存储;后来的 Llama 还纳入了 Arxiv 论文(92 GB)、StackExchange(78 GB)。
成本方面:GPT-3 未公开其训练数据集;可参考的同类项目是 Dolma(3 万亿词元的开放语料库,包含部分可能有版权的内容)。据估计,预训练 GPT-3 的云计算费用约为 460 万美元——「从零复现预训练」的成本量级由此可估。比起从零复现,更现实的路径是:许多预训练 LLM 已开源,用较小的数据集微调一轮,即可在特定任务上得到可用的模型。
|
真正改变行业工作方式的是零样本/少样本能力本身:在此之前,更换任务意味着重新收集数据、标注、训练,周期以月计;在此之后,很多任务变成「把任务描述写清楚」。提示词工程(prompt engineering)由此成为一项专门技能。 |
1.9 三阶段路线图:各阶段的成本与门槛
「复现 ChatGPT」听起来需要数百万美元预算与机房。拆开看:三个阶段里有两个能在个人电脑上完成;成本最高的预训练阶段,也可以通过加载公开权重跳过。

| 阶段 | 内容 | 时间 | 硬件门槛 |
|---|---|---|---|
阶段 1 |
分词 / 滑窗 / 注意力 / GPT 骨架,跑通 forward |
1–3 天 |
任何笔记本 |
阶段 2A |
小语料自己预训练(第 5 章 10 轮实测) |
CPU 8 分钟 / GPU 10–15 秒 |
GPU 强烈建议 |
阶段 2B |
加载 OpenAI 官方权重,跳过预训练 |
几分钟 |
16 GB+ 显存更稳 |
阶段 3 |
分类 / 指令 / LoRA 微调 |
几十分钟~几小时 |
全量 medium 需 12 GB;LoRA 6 GB 即可 |
各阶段的主要门槛:架构实现以工程量为主,预训练以算力预算为主,微调以数据质量与调参经验为主。
路线图之外还有一段:三阶段叙事止于微调,真实的 ChatGPT 在此之后还有 RLHF——训练模型给出更符合人类偏好的回答。这一阶段对最终体验影响显著,公开的技术细节也最不完整。
最后梳理 GPT 系列的演进,明确本教程复现的对象:
-
GPT-1(Improving Language Understanding by Generative Pre-Training)
-
GPT-2:同一套方法放大规模,本教程复现其最小版本
-
GPT-3:更多参数与数据
-
ChatGPT:在 GPT-3.5 上沿用 InstructGPT 的路线做对齐
GPT-3 发布于 2020 年,96 层 Transformer。以大模型的迭代速度看,它已不算新;但 Meta 的 Llama 等后续架构仍基于相同的基本理念,只做了些许调整。理解 GPT,仍是在理解当前主流技术的基础。
1.10 本教程的结构地图
传统的「三阶段」划分,对应本教程的 Part A + Part B;在此之上还加了 Part C——把模型做成产品:
| 篇 | 章 | 一句话 |
|---|---|---|
准备 |
一次 setup 全书就位 + LibTorch 写法热身 |
|
Part A 实现 GPT |
第 1 章(本章)→ 第 2 章 文本→词元→向量 → 第 3 章 注意力 → 第 4 章 组装 GPT-2 |
从零实现 124M 的 GPT-2 |
Part B 训练 GPT |
第 5 章 预训练 → 第 6 章 分类微调 → 第 7 章 指令微调 → 第 8 章 训练工程化 → 第 9 章 LoRA |
从零完成全部训练环节 |
Part C 从模型到产品 |
第 10 章 HTTP 服务 → 第 11 章 NL→Bash → 第 12 章 Function Calling → 第 13 章 推理模型 |
四个已实测的独立工程 |
教程章节、代码目录、核心实现的对照索引见 附录 B。
1.11 术语速查表
| 术语 | 英文 | 一句话定义 |
|---|---|---|
大语言模型 |
LLM |
理解并生成类人文本的神经网络 |
参数 |
parameter |
神经网络中可调整的权重,训练时不断更新以预测下一个词 |
词元 |
token |
模型读取文本的基本单位 |
原始文本 |
raw text |
无任何标注信息的普通文本 |
预训练 / 微调 |
pre-training / fine-tuning |
大规模无标注数据上的初始训练 / 小规模标注数据上的任务再训练 |
基础模型 |
foundation model |
预训练完成后的 LLM(能生成文本,但不按指令回应) |
自监督学习 |
self-supervised learning |
从输入数据自身生成标签(下一词即标签) |
自回归 |
autoregressive |
把之前的输出作为未来预测的输入 |
自注意力 |
self-attention |
衡量序列内词元间相对重要性的机制 |
涌现 |
emergence |
完成未经明确训练的任务的能力 |
零样本 / 少样本 |
zero-shot / few-shot |
无示例泛化 / 少量示例学习 |
二元语法 |
bigram |
只看前一个词预测下一个词的最古老语言模型 |
本章小结
-
语言模型是「预测下一个词的机器」:bigram 用一张计数表完成这个任务,但「只能看前一个词」的限制使它输出退化——后续七十年的进展,就是不断扩大模型能看到的上下文。
-
概念坐标:AI ⊃ 机器学习 ⊃ 深度学习 ⊃ LLM;经典机器学习与深度学习的分界在「特征由谁构造」,不在是否使用神经网络。
-
大模型与 bigram 做的是同一个任务——下一词预测 + 自回归;任务本身简单,能力随规模增长(涌现的真伪,学界仍有争议,可能部分源于评测指标)。
-
自建模型的四大优势(性能/隐私/端侧/自主)各有具体依据,但门槛在训练之后的数据与维护投入。
-
两阶段训练:预训练(自监督、无标注)产出基础模型;微调沿分类与指令两条路线使模型适配任务。
-
Transformer 一份架构两个模块:GPT 取解码器负责生成(训练数据近乎无限),BERT 取编码器负责理解。
-
GPT-3 的数据与成本:4990 亿词元的语料实际训练了 3000 亿,训练费用估计约 460 万美元——因此三阶段路线图中,预训练可以加载公开权重跳过,微调是个人实践的主战场。
自测清单
能不回看就答出这些,本章就算过关:
-
大语言模型的训练目标是什么?bigram 和 GPT-3 做的是同一件事吗?差别在哪?
-
bigram 为什么会输出
the the the…?调温度能解决这个问题吗? -
「大」在「大语言模型」里指哪两件事?涌现是什么意思?支持和质疑它的人分别拿出了什么证据?
-
经典机器学习与深度学习的核心区别是什么?(提示:不是网络层数)
-
为什么 LLM 的预训练不需要人工标注?标签从哪来?
-
预训练的产物叫什么?它有哪两条微调路径,数据集形态分别是什么?
-
自建领域模型相比调用通用 LLM 的四个优势是什么?自建的真实门槛在哪?
-
BERT 和 GPT 分别取了 Transformer 的哪一半?训练目标和擅长任务有何不同?
-
为什么生成路线(解码器)最终占据主导?(提示:训练数据来源)
-
GPT-3 数据集总计 4990 亿词元,实际只训练了 3000 亿——论文解释原因了吗?
习题
-
跑通 bigram lab,把训练语料换成你自己写的几段话(保持空格分词), 观察词表大小 V 与输出退化现象的变化。
-
用
--temperature 0.1和--temperature 2.0各跑一次采样, 回答:温度调低趋近于哪种解码?调高呢? -
找一篇 AI 相关的宣传文案,用两个问题各分析一次: 「它说的 AI 是哪一层?」「这个『突破』用的什么评测指标?」 记录每个问题能否得到明确答案。
-
(预告)第 5 章会实现温度 + Top-k 的完整解码流程——到时候回头对比 bigram 采样的差距。
拓展阅读
-
Vaswani et al., 2017, Attention Is All You Need: https://arxiv.org/abs/1706.03762
-
Radford et al., Improving Language Understanding by Generative Pre-Training(GPT-1): https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
-
Brown et al., 2020, Language Models are Few-Shot Learners(GPT-3,本章数据规模的出处): https://arxiv.org/abs/2005.14165
-
Schaeffer et al., 2023, Are Emergent Abilities of Large Language Models a Mirage?(涌现争议的反方): https://arxiv.org/abs/2307.09288
-
香农 1948《A Mathematical Theory of Communication》(bigram 思想的源头): https://en.wikipedia.org/wiki/A_Mathematical_Theory_of_Communication
-
Holtzman et al., 2020, The Curious Case of Neural Text Degeneration(贪心解码陷入重复的原始研究,1.1 节「每步取最大常输给采样」的出处): https://arxiv.org/abs/1904.09751
-
本章提到的开源基座(可下载对照体验):GPT-2 https://huggingface.co/openai-community/gpt2 | Llama https://huggingface.co/meta-llama | Qwen(魔搭) https://modelscope.cn/organization/Qwen