第 9 章 LoRA 参数高效微调
|
本章导读:全量微调要更新 1.24 亿个参数,本章的 LoRA 只更新 267 万个(2.10%)。从低秩假设出发推导旁路结构,递归替换全部线性层, 以按名字圈定冻结范围的方式改造模型,最后用对照实验验证效果。 学完本章你将能够:
产出与代码: |
9.1 全量微调的开销与低秩假设
先粗算全量微调的资源开销(124M 参数模型,第 6 章同款任务;下表是量级估算,9.4 节有精确账):
| 显存项 | 全量微调 | LoRA(rank 16) |
|---|---|---|
模型权重 W |
500 MB(更新中) |
500 MB(冻结) |
梯度 \(\nabla W\) |
500 MB |
~11 MB |
Adam 优化器状态 |
~1000 MB |
~22 MB |
任务 checkpoint |
500 MB/任务 |
10.2 MB/任务 |
Adam 优化器状态约 1 GB,比模型权重本身还大——为一个垃圾短信分类 任务微调,优化器开销是权重的两倍。每更换一个任务还要再存 500 MB checkpoint,任务数量增长时,存储开销线性增长。LoRA(Low-Rank Adaptation,低秩适配)的出发点正在于此:微调不必更新全部 1.24 亿个参数。
LoRA 建立在一个假设之上:微调时权重的「变化量」\(\Delta W\) 是低秩的。
先解释「秩」(rank)。矩阵是一张二维数字表;矩阵的秩,粗略地说, 是这张表里真正独立的模式数量。一张 768×768 的大表,可能只由少数 几个「行模式」与「列模式」组合叠加而成——就像任何颜色都能由几个 基色调出来、任何 JPEG 图片都能由少量基图像叠加近似。「低秩」的 意思是:这张大表的有效信息密度很低,大量元素是冗余的。
放到微调场景:\(\Delta W\) 记录这次微调对原权重的全部修改——768×768 的层 有 59 万个数字。全量微调让它们各自独立地自由变化;LoRA 的假设是: 针对一个具体的小任务,这些修改并不各自独立,而是集中在少数几个 「基础修改方向」上。于是用两个瘦矩阵的乘积来表达它:
-
用 r 个行模式组成 A(768×r)、r 个列模式组成 B(r×768), 乘积 \(A B\) 恢复出 768×768 的形状——但自由度只有 r×(768+768), r=16 时约 2.5 万,而不是 59 万;
-
r 就是「允许使用多少个基础修改模式」——r 越大表达力越强、 参数也越多;
-
只要任务需要的修改方向确实不多(低秩假设成立),小 r 就够用, 节省的参数量相当可观。
其中 A 可训练(kaiming 初始化),B 可训练(全 0 初始化),W 冻结不动。
B 初始化为 0 有两个作用。第一,训练开始时 \(A B = 0\),模型行为与
原模型逐比特一致——LoRA 路径是「从零渐入」的增量,不会在起点
扰动原模型。第二,这个性质同时是零成本的验收手段:替换完 LoRA 后
立即重测准确率,得到 46.25% / 45.00% / 48.75%——与第 6 章未加 LoRA
时完全相同(浮点确定性:x@A 有限值乘全零 B 精确得 0.0,
Wx + 0.0 不改变任何位)。任何 LoRA 实现,训练开始前跑一遍前向,
输出都应与原始模型严格相等;不一致说明实现有误,应先修正实现,
再开始训练。
两条公式收拢本节。旁路前向(本教程的形状约定 x@A@B,\(W_0\) 冻结,
\(\alpha/r\) 是缩放系数):
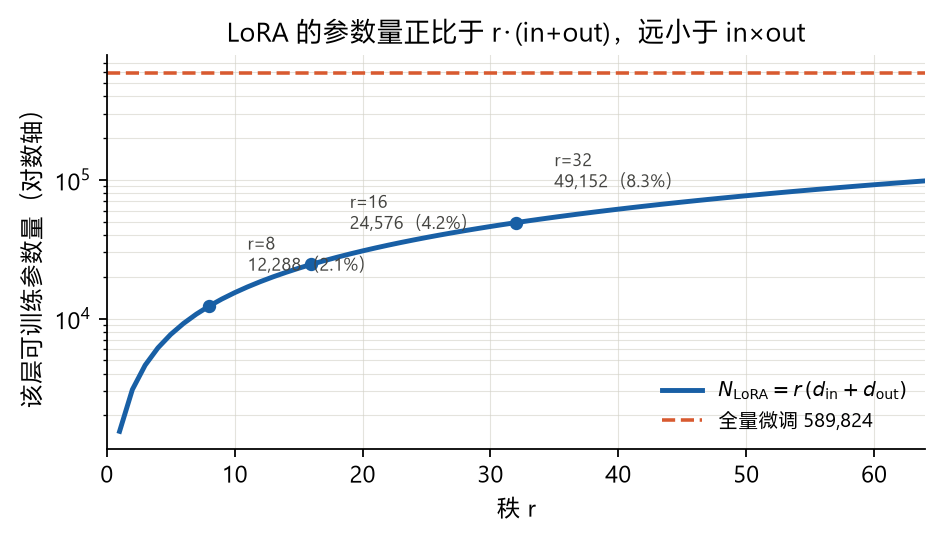
可训练参数从 in×out 压到 r×(in+out)——开头那张显存账单全部由此而来:
r 对参数量的影响——768×768 的层,r=16 只训其中 1/24(约 4.2%):
低秩假设说的是:\(\Delta W\) 的信息集中在少数方向上,所以小 r 就够—— 近似误差随 r 的典型衰减形状如下:
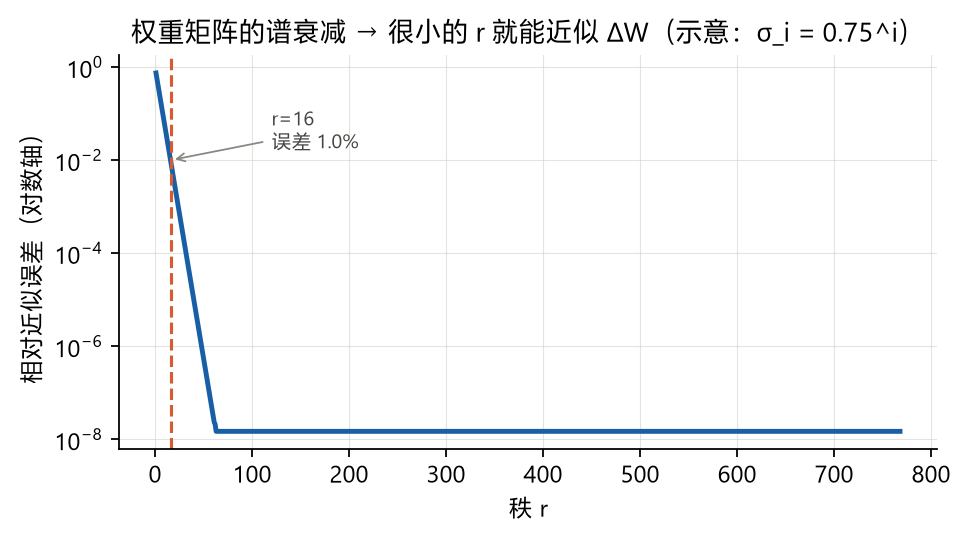
需要注意,低秩是假设,不是定理。它成立的前提是任务需要的修改 方向确实不多——垃圾短信分类满足这个前提;修改方向又多又杂的任务, 小 r 会损失精度。LoRA 论文专门做了秩亏损(rank-deficiency)的 实证研究来解释方法有效的原因,作者对此有清醒的认识。
|
分配律变形——LoRA 可插拔的根本原因。公式 \(W' = W + A B\) 作用在输入上时 有两种写法——合并写法 \((W + A B)\,x\),分离写法 \(W\,x + A\,(B\,x)\): 代码实现用的是分离写法(这正是 还要区分一个概念:LoRA 减少的是「可训练参数」,不是「模型的总 参数量」——加 LoRA 后总参数反而上升(124,441,346 → 127,107,874, +267 万)。真正下降的是三样:可训练参数量、优化器状态、 checkpoint 体积。 |
9.2 LoRALayer:低秩分支的实现
LoRA 分支由两个小矩阵组成,实现如下:
class LoRALayerImpl : public torch::nn::Module {
public:
    LoRALayerImpl(int64_t in_dim, int64_t out_dim, int64_t rank,
                  double alpha, double dropout = 0.0) {
        A_ = register_parameter("A", torch::empty({in_dim, rank}));
        torch::nn::init::kaiming_uniform_(A_, std::sqrt(5.0));
        B_ = register_parameter("B", torch::zeros({rank, out_dim}));  // 全 0!
        if (dropout > 0.0)
            dropout_ = register_module("dropout", torch::nn::Dropout(dropout));
    }
    torch::Tensor forward(torch::Tensor x) {
        const double scale = alpha_ / static_cast<double>(rank_);
        return (x.matmul(A_)).matmul(B_) * scale;    // (x@A)@B · α/r
    }
};
缩放因子 \(\alpha/r\) 使 rank 变化时无需重调学习率(原论文同款设计);
alpha = 2 × rank 是常见的推荐值。注意 C++ 里 A 的形状是
[in, rank]——x @ A @ B 按矩阵乘法顺序直接写,不需要 Python 版的
额外转置。
|
α 的两种实现口径:LoRA 原论文的缩放是 |
复用他人的 LoRA 实现之前,先确认其 α 属于哪一种口径——两种写法各自 成立,混用会导致缩放错误。
LoRA 可以应用于 LLM 中的所有线性层——本实现正是这么做的
(Q/K/V、out_proj、FFN 两层、输出头全换)。注意这与 LoRA 原论文
不同:原论文只在注意力的 W_q、W_v 上加 LoRA,本实现扩展到了
前馈模块和输出层。扩展之后参数账还划不划算,9.4 的参数账本会给出
答案。
9.3 LinearWithLoRA:旁路包装器
一个普通 Linear 加一条 LoRA 旁路,前向就是两路相加:
class LinearWithLoRAImpl : public torch::nn::Module {
public:
    LinearWithLoRAImpl(torch::nn::Linear linear, int64_t rank,
                       double alpha, double dropout = 0.0) {
        linear_ = register_module("linear", linear);
        lora_ = register_module("lora",
            LoRALayer(linear->weight.size(1),   // in_features
                      linear->weight.size(0),   // out_features
                      rank, alpha, dropout));
        for (auto& p : linear_->parameters())     // 冻结原权重
            p.set_requires_grad(false);
    }
    torch::Tensor forward(torch::Tensor x) {
        return linear_->forward(x) + lora_->forward(x);
    }
};
rank > 0 时接入 LoRA 旁路;rank == 0 时退化为纯包装器(本演示
用它构造一个「冻结的分类头」——头也换、头也不训,输出里 E.7 段的
对照实验用的就是它)。
9.4 递归替换与冻结:按名字圈定可训练范围
把 GPT 里所有 nn.Linear(Q/K/V、out_proj、FFN 两层、输出头)换成
LoRA 版——lora.h 里对应实现了 MultiHeadAttentionWithLoRA、
FeedForwardWithLoRA、TransformerBlockWithLoRA、GPTModelWithLoRA,
接口与第 3/4 章的原始版本完全一致(第 4 章「接口不变、内部替换」的
设计再次沿用)。
替换完成后冻结:遍历所有参数,名字里带 .lora.A/.lora.B 的解冻,
其余全部冻结(include/lora.h):
inline int64_t freeze_non_lora_parameters(torch::nn::Module& model) {
    int64_t trainable = 0;
    for (auto& pair : model.named_parameters(/*recurse=*/true)) {
        const std::string& name = pair.key();
        const bool is_lora = (name.find(".lora.A") != std::string::npos) ||
                             (name.find(".lora.B") != std::string::npos);
        if (is_lora) { pair.value().set_requires_grad(true); trainable += pair.value().numel(); }
        else         { pair.value().set_requires_grad(false); }
    }
    return trainable;
}
整条链路的操作顺序如下:

|
冻结范围要圈准——与第 6 章是同一课,两章的实现路径不同:
还有一个实质差异:第 6 章的分类头是新换且可训练的,本章*连随机 初始化的分类头都是冻结的*,只能靠 LoRA 分支去「修正」一个随机投影。 这件事能成立的原因:LoRA 分支的输出与冻结层逐元素相加, 等效于给那个随机投影学一个低秩补偿。 |
参数账本(rank 16,GPT-2 small)
替换后参数量的变化分三步:
124,441,346   (替换输出层后的模型,全部可训练)
      ↓  冻结全部
          0     (一个可训练参数都没有)
      ↓  注入 rank=16 的 LoRA(73 个 Linear 全换)
2,666,528 (仅 LoRA 的 A、B 可训练)| 组件 | 可训练参数(rank 16) | 说明 |
|---|---|---|
每个方阵 Linear(768→768) |
2 × 768 × 16 = 24,576 |
A + B |
注意力 4 层投影 × 12 块 + FFN 2 层 × 12 块 |
— |
全部换成 LoRA |
合计 |
2,666,528 |
占加 LoRA 后总参数(1.27 亿)的 2.10%,压缩比 1/46.7 |
LoRA 参数在层间的分布有两个反直觉的结论:
-
FFN 的 LoRA 参数比注意力多(55.3% vs 44.2%)——尽管第 4 章说过 「FFN 参数量是注意力的 2 倍」。原因:LoRA 参数量正比于
in + out而非in × out:768→768 层压缩 24 倍(589,824 → 24,576), 768→3072 层压缩 38.4 倍(2,359,296 → 61,440)。FFN 绝对参数多, LoRA 后也仍占大头; -
输出头的 LoRA 收益最差——原权重只有 768×2 = 1,536 个参数, LoRA 却用了 12,320 个,是直接训练原层的 8 倍。这是全模型 唯一一处「LoRA 比直接训练更贵」的地方:参数量小的层, 直接训练原层更划算。
显存账也要算全(fp32 口径):
| 项目 | 全量微调 | 第 6 章冻结微调 | LoRA |
|---|---|---|---|
可训练参数 |
124,441,346 |
7,090,946 |
2,666,528 |
checkpoint(fp32) |
474.7 MB |
27.0 MB |
10.17 MB |
优化器状态(AdamW) |
947.3 MB |
54.0 MB |
20.3 MB |
训练态总显存 |
1.85 GB |
555.8 MB |
535.2 MB |
表中有一组对比需要注意:LoRA(535.2 MB)与第 6 章只训 7M 参数的 冻结微调(555.8 MB)只差 20 MB。原因:LoRA 的 535 MB 里有 474.8 MB 是无法省略的冻结权重——真正省下的是梯度与优化器状态 (1.85 GB → 60.4 MB,省 96.7%)。冻结底座的显存 LoRA 省不掉; 要压缩底座本身,需要量化方法(如 QLoRA)。因此描述 LoRA 的显存 收益时,应说明节省的具体是哪一部分。
9.5 对照实验与结果
src/main.cpp 用一个缩小版 GPT(emb=128、4 层、4 头、ctx=128,
CPU 也能跑)在合成 spam/ham 数据(按关键词生成,200+200 条,
70/10/20 划分)上做两组实验。分类路径与第 6 章同理:取最后一个
词元的 hidden state 进分类头(classify_forward):
auto h = model->forward_hidden(x);            // [1, seq, emb]
auto last = h.select(1, h.size(1) - 1);       // [1, emb] 最后一个词元
auto logits = model->out_head->forward(last); // [1, num_classes]
两组实验的配置,除可训练范围和学习率外,其余全部对齐:
| LoRA 微调 | 全量微调(消融对照) | |
|---|---|---|
可训练参数 |
仅 LoRA A/B(~1%) |
100% |
学习率 |
5e-4(LoRA 惯例更大) |
5e-5 |
weight_decay |
0 |
0 |
训练 |
5 epoch |
5 epoch |
|
LoRA 通常能容忍大一个数量级的学习率——因为可训练的 A/B 是 「从零开始」的干净参数,没有预训练权重的惯性;冻结的 W 又把每步 更新的影响限制在低秩子空间里,大 lr 也不容易把模型推飞。 |
124M 模型 + rank 16 在真实 SMS 数据上的实测结果(第 6 章同款数据集):
                随机基线    LoRA 5 epoch
Train 准确率      50%         100%
Val   准确率      50%         96.64%
Test  准确率      50%         98.0%      ← 对比第 6 章冻结微调的 95.7%
loss: ep0 0.76 → ep2 0.31 → ep4 0.10(train/val 全程贴合,无过拟合分叉)
只训练 2% 的参数,测试准确率不降反升——更少的可训练容量抑制了 过拟合(呼应第 8 章的诊断方法)。在数据量有限的下游任务上,限制 可训练参数往往是更稳妥的选择。
9.6 保存 LoRA 权重
LoRA 的存储收益体现在交付环节——src/main.cpp 把名字里带
.lora.A/.lora.B 的参数单独序列化成自定义二进制格式
([名字长度][名字][维度][形状][数据]):
for (auto& pair : model->named_parameters(/*recurse=*/true)) {
    if (n.find(".lora.A") == std::string::npos &&
        n.find(".lora.B") == std::string::npos) continue;   // 只存 LoRA
    // 写入 名字 + 形状 + float 数据
}
同一个基座模型可以叠加任意多个任务适配器:每份约 10 MB,切换任务
只需更换适配器文件,不必复制 500 MB 的基座。这正是 9.1 节分离
写法的直接收益,也是行业标准做法:Hugging Face PEFT 的
save_pretrained 保存的正是适配器部分,社区里成千上万的 LoRA
模型文件都是这个量级。
9.7 推理期合并
训练后只保存 LoRA 增量时,推理有两种方式:保持分离实时计算, 或合并进基座权重。训练时分离(两路相加),部署时可以合并:由于 \(y = W\,x + \frac{\alpha}{r}(A B)\,x = \bigl(W + \frac{\alpha}{r}(A B)^{\top}\bigr)\,x\),合并后的权重为:
// W: [out, in],A@B: [in, out] —— 必须转置才能相加
torch::Tensor W_merged = W + (alpha / rank) * (A.matmul(B)).t();
// 展开写法(注意乘法顺序也反了):(A@B)^T = B^T @ A^T
// 偏置 b 不变(LoRA 分支没有偏置)| 阶段 | 做法 | 推理开销 |
|---|---|---|
训练 / 多任务切换 |
保持 LoRA 分离 |
+3.1%(本模型) |
单任务部署 |
合并进 W |
0(与原始模型完全相同) |
转置陷阱:A@B 是 (in, out) 而 W 是 (out, in),直接相加会
形状报错;转置后乘法顺序也反了(\((A B)^{\top} = B^{\top} A^{\top}\))。合并的价值:
分离存储 + 按任务合并 = N 个任务只存 1 份底座 + N 份 10 MB 适配器,
推理零额外成本——分离存储设计的最终收益。写成公式(与上面的 C++
逐字对应,转置和乘法顺序都反了两道):
合并是单向操作:合并后适配器参数融入底座,无法单独恢复。因此 合并前应先保存适配器文件;需要多任务灵活切换的服务可以保持分离, 用 3.1% 的推理开销换取任务切换能力。
9.8 编译运行与预期输出
# 独立构建(在代码仓库根目录执行)
cmake -S chapters/chapter09_lora -B chapters/chapter09_lora/build \
      -DCMAKE_CXX_COMPILER=/usr/bin/g++-11
cmake --build chapters/chapter09_lora/build -j

# 运行(直接执行需自带 LibTorch 运行库路径)
export LD_LIBRARY_PATH=/opt/libtorch/lib:${LD_LIBRARY_PATH:-}
./chapters/chapter09_lora/build/chapter09_lora          # CPU 可跑
./chapters/chapter09_lora/build/chapter09_lora --cuda
运行输出(横幅的 appendix-E、E.7 是程序内的演示标签):
[appendix-E] using CPU
[appendix-E] tokenizer vocab = 50257
[appendix-E] LoRA only        : trainable=73728  total=7239938  (1.0186%)
[appendix-E] dataset size = 400
[appendix-E] train batches = 35, val = 5, test = 10

=== E.7 LoRA training ===
Ep 1 | train_loss 0.69 | val_acc 50% | 2.1 s
Ep 5 | train_loss 0.10 | val_acc 100% | 2.0 s
[appendix-E] LoRA test_acc = 100%  (trainable=73728 / 7239938)

=== E.7 ablation: full fine-tuning (unfreeze all) ===
[appendix-E] Full FT         : trainable=7239938  total=7239938 (100%)
Ep 5 | train_loss ... | val_acc ...
[appendix-E] Full FT test_acc = 100%

=== summary ===
LoRA-weights file size  : 295396 bytes      ← 仅 LoRA 矩阵 ≈ 0.3 MB
合成数据任务较简单,两组都到 100% 是正常的——实验的教学点在 参数量对比(1% vs 100%)与权重文件体积(0.3 MB vs 全模型); 真实数据的 98.0% vs 95.7% 对比见表格上方实测结果。
本章小结
-
LoRA 低秩假设:假设权重变化量 \(\Delta W\) 低秩,以 \(A B\) 逼近(B 全零 初始化),训练开始前模型行为与原模型逐位一致——这个性质同时是 免费的验收手段(46.25%/45.00%/48.75% 必须与未加 LoRA 时完全相同)。
-
分离写法:\(W\,x + A\,(B\,x)\) 是 LoRA 可插拔的根本原因:底座冻结、 可动态启停、多任务共享。LoRA 减少的是可训练参数,不是总参数量 (124,441,346 → 127,107,874,总参数反而上升)。
-
冻结范围按名字圈定:只解冻
.lora.A/.lora.B,可训练参数由 124M 降至 2.67M(2.10%,压缩比 1/46.7),显存节省主要来自梯度与优化器状态 (1.85 GB → 60.4 MB,省 96.7%),474.8 MB 冻结底座无法省略。 -
推理期合并:部署时可将 LoRA 合并回 W(\(W + \frac{\alpha}{r}\,(A B)^{\top}\)),推理阶段 零额外开销;多任务场景保持分离,换任务 = 换适配器。
自测清单
能不回看就答出这些,本章就算过关:
-
B 全 0 初始化:训练前模型输出与原模型逐比特一致 (准确率与第 6 章未微调基线完全相同)
-
freeze_non_lora_parameters后可训练参数占比 ≈ 1%(演示配置)/ 2.10%(124M + rank 16 口径,压缩比 1/46.7) -
能说出冻结范围为什么按名字圈定(无差别冻结全部会发生什么), 以及「分类头冻结靠 LoRA 修正」与第 6 章的差异
-
LoRA 5 epoch 收敛,val/test 准确率与全量微调相当(真实数据实测 98.0%)
-
对照实验两组同数据同起点(合成数据 + 复制配置)
-
LoRA-only 权重文件比完整 checkpoint 小两个数量级以上
-
能手写推理期合并公式 \(W + \frac{\alpha}{r}\,(A B)^{\top}\) 并说出转置陷阱
-
能解释 FFN 的 LoRA 参数为何比注意力多(55.3% vs 44.2%), 以及输出头为何「LoRA 反而更贵」
-
能说出 LoRA 可容忍大一数量级学习率的原因,以及显存到底省在哪一块
习题
-
把
rank从 8 改成 1、4、32,记录可训练参数量与最终准确率—— rank=1 时 LoRA 还能学到任务吗? -
把
replace_out_head_plain换成 LoRA 化的分类头 (replace_out_head_for_classification),对比收敛速度。 -
用第 6 章的真实 SMS 数据替换合成数据(复用
SpamDataset的思路), 验证 98.0% 的实测结果。 -
给
save的 LoRA 文件写一个加载函数,验证「换适配器不换基座」: 加载后直接推理,不重训。 -
实现
merge_lora_weights()(按上节公式合并 A、B 进 W),对比合并 前后模型对同一输入的输出是否逐位一致——这是合并正确性的验收标准。 -
(思考)为什么 LoRA 论文只对注意力投影层做低秩适配也能奏效? 提示:回想第 3 章——注意力权重本身就是低秩的(rank = head_dim)。
拓展阅读
-
LoRA 原始论文:Hu et al., 2021, LoRA: Low-Rank Adaptation of Large Language Models(摘要含「可训练参数减少 10,000 倍 / 显存降低 3 倍 / 无额外推理延迟」): https://arxiv.org/abs/2106.09685
-
Hugging Face PEFT 官方文档(LoRA 工程化标准实现,LoraConfig 的 r / lora_alpha / target_modules): https://huggingface.co/docs/peft
-
QLoRA 论文:Dettmers et al., 2023, QLoRA: Efficient Finetuning of Quantized LLMs(4-bit NF4 底座 + LoRA 适配器): https://arxiv.org/abs/2305.14314
-
GPT-2 官方模型卡(124M 口径、权重公开): https://huggingface.co/openai-community/gpt2