第 3 章 注意力机制:四种变体的演进
|
本章导读:从零实现注意力机制的四个变体——简单自注意力、可训练自注意力、因果注意力、多头注意力。每个变体只在前一个的基础上增加一样东西,最终得到 GPT-2 实际使用的注意力模块。 本章是全书数学推导最密集的一章。代码总量不足 250 行,难点在理解,不在写代码。 学完本章你将能够:
产出与代码: |
3.1 注意力的由来:RNN 的固定向量瓶颈
先看 2014 年机器翻译系统的工作方式。编码器把源句子从头到尾读一遍,把全部含义压缩成一个固定长度的向量;解码器拿着这个向量逐词翻译。
问题出在「固定长度」上。五个词的短句装得下,五十个词的长句也得装进同一个尺寸的向量。装不下的信息,只能丢弃。解码端的处境更受限:它只能拿到压缩后的最终向量,无法回头访问编码过程中的中间隐藏状态。相当于让译者只凭脑中最后一段印象翻译全句。句子越长、依赖关系越复杂,信息损失越严重。这是原始论文中明确记载的缺陷。
改进分两步:
-
2014 年:Bahdanau 注意力给这套架构补上关键一环。解码器每译一个词,允许它回头查看源句的所有位置,按相关程度加权取信息。翻译「她」时多关注指代对象的位置,翻译动词时多关注原句的动词。「相关程度」就是权重;
-
2017 年:研究者进一步发现,既然解码器可以随时访问全部位置,RNN 逐步读入的结构就不再必要。让每个词直接与所有词计算一遍相关度即可——这就是自注意力,Transformer 架构由此诞生。
| 关注的对象 | 典型场景 | |
|---|---|---|
自注意力 |
单个输入序列内部的不同位置 |
句子中词与词之间、图像中像素之间 |
传统注意力 |
两个不同序列元素之间的关系 |
seq2seq 翻译中「输入序列 ↔ 输出序列」 |
自注意力的正式定义:在计算序列表示时,允许输入序列中的每个位置关注同一序列中的所有位置。它的产物叫上下文向量——为每个词元算出一个新表示 \(z^{(i)}\),融合全序列所有词元的信息。

本章按这条路线逐节实现,每个箭头只增加一样东西。全程使用同一个 6 词元的小例子,从输入算到输出:
// 贯穿示例:"Your journey starts with one step."
torch::Tensor make_inputs() {
    return torch::tensor({{0.43f, 0.15f, 0.89f},  // Your   (x^1)
                          {0.55f, 0.87f, 0.66f},  // journey(x^2)
                          {0.57f, 0.85f, 0.64f},  // starts (x^3)
                          {0.22f, 0.58f, 0.33f},  // with   (x^4)
                          {0.77f, 0.25f, 0.10f},  // one    (x^5)
                          {0.05f, 0.80f, 0.55f}}  // step   (x^6)
    );                                            // (6, 3):6 个词元,嵌入维度 3
}
3.2 简单自注意力:三步计算
先实现最基础的版本:不带任何可训练参数。计算分三步,每一步的设计都有明确依据。
第一步:点积计算相似度。 自注意力要回答的问题是:每个词元与其他词元有多相关。用什么衡量相关度?点积——逐元素相乘再求和。点积为什么适合衡量相似度?用单位向量就能验证:方向相同,点积最大;互相垂直(方向上没有重合成分),点积为零;方向相反,点积为负。点积累积的正是两个方向重合的程度:重合越多,累积值越大。第 2 章说过,嵌入把语义编进了向量:语义相近的词,向量方向也相近。于是点积把「语义相近程度」变成了一个可以比较、可以求导的数。
第二步:softmax 归一化权重。 原始分数有大有小、有正有负,softmax 把它们归一化成一组权重。不用「除以总和」这种朴素归一化,理由有三:softmax 对极值的处理更好;训练时梯度特性更友好;输出保证非负、每行之和为 1,可以解释为概率或相对重要性。工程上还要注意:朴素 softmax 在输入过大或过小时会数值溢出,生产代码应使用框架内置版(内部有数值稳定化处理)。
第三步:加权求和。 按权重把所有词元的向量混合,得到当前词元的上下文向量,其中融合了全句的信息。
以 journey(\(x^2\))为查询,逐元素实现一遍:
torch::Tensor query = inputs.index({1});
// ① 相似度:query 与每个输入的点积
std::vector<torch::Tensor> scores;
for (int64_t i = 0; i < inputs.size(0); ++i)
    scores.push_back(torch::dot(inputs.index({i}), query));
auto attn_scores_2 = torch::stack(scores);

// ② 归一化:直接除以总和可行,但推荐 softmax(对大数值更稳定、可求导)
auto attn_weights_2 = torch::softmax(attn_scores_2, 0);

// ③ 上下文向量:按权重加权所有输入
torch::Tensor context_vec_2 = torch::zeros_like(query);
for (int64_t i = 0; i < inputs.size(0); ++i)
    context_vec_2 += attn_weights_2.index({i}) * inputs.index({i});
运行结果(确定性输出,可逐位核对):
attn_scores_2 = [0.9544, 1.4950, 1.4754, 0.8438, 0.7070, 1.0865]
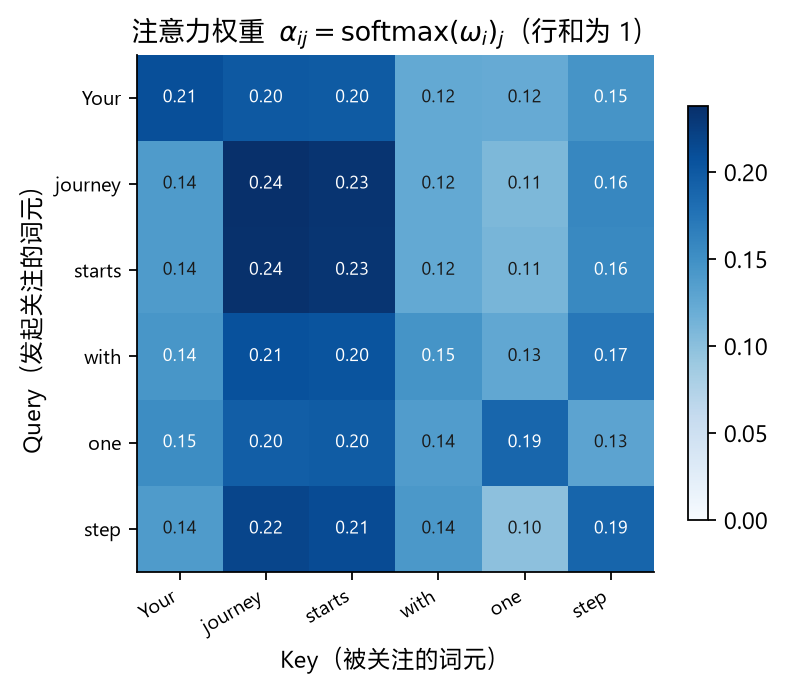
attn_weights_2 (softmax) = [0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581]   ← 和为 1
context_vec_2 = [0.4419, 0.6515, 0.5683]
\(x^2\) 对自己和 \(x^3\) 的权重最大(0.2379、0.2333)。journey 和 starts 语义相近,这正是点积相似度下的合理结果。
推广到所有词元时,双重循环可以整体换成矩阵乘法。这一步是后续所有实现的雏形:
auto attn_scores     = inputs.matmul(inputs.t());   // (6,6) 全部两两点积
auto attn_weights    = torch::softmax(attn_scores, -1);  // 每行归一化
auto all_context_vecs = attn_weights.matmul(inputs);     // (6,3)
矩阵乘法得到的 all_context_vecs 与逐步算出的 context_vec_2 完全一致。6×6 的注意力权重矩阵如下——每行是一个查询对全部键的 softmax:
这个无参数版本有一个重要价值:输出完全由输入决定,每个数都能手算验证,适合作为后续所有实现的调试基准。
3.3 可训练的自注意力:查询、键、值
无参数版本有一个根本缺陷:相关度完全由原始嵌入向量决定,模型无法学习调整关注重点。本节引入可训练权重。
SelfAttentionV1:三组投影矩阵
为每个词元计算三个角色向量,各经过一个独立的投影矩阵:
class SelfAttentionV1Impl : public torch::nn::Module {
public:
    SelfAttentionV1Impl(int64_t d_in, int64_t d_out) {
        W_query  = register_parameter("W_query",  torch::rand({d_in, d_out}));
        W_key    = register_parameter("W_key",    torch::rand({d_in, d_out}));
        W_value  = register_parameter("W_value",  torch::rand({d_in, d_out}));
    }
    torch::Tensor forward(torch::Tensor x) {
        auto keys    = x.matmul(W_key);
        auto queries = x.matmul(W_query);
        auto values  = x.matmul(W_value);
        auto attn_scores  = queries.matmul(keys.t());               // ω
        auto attn_weights = torch::softmax(
            attn_scores / std::sqrt(keys.size(-1)), -1);            // 缩放!
        return attn_weights.matmul(values);
    }
    torch::Tensor W_query, W_key, W_value;
};
TORCH_MODULE(SelfAttentionV1);-
Query(查询):当前词元在寻找什么信息;
-
Key(键):每个词元可供检索的标签;
-
Value(值):匹配成功后实际提供的信息。
三个角色借自信息检索:搜索词是 query,网页关键词索引是 key,点开看到的正文是 value。注意力做的就是这种匹配:拿每个位置的 query 与所有 key 计算相似度;匹配度越高,对应 value 在加权求和里的份额就越大。三个投影矩阵可训练——模型由此学会关注哪里。这是注意力从固定机制变成可学习行为的关键一步。
缩放因子 \(\sqrt{d_k}\)
attn_scores / std::sqrt(keys.size(-1)) 这个除法不是随意的,推理链条如下:
-
类 GPT 模型的嵌入维度动辄上千 → 两个大维度向量的点积数值可能非常大;
-
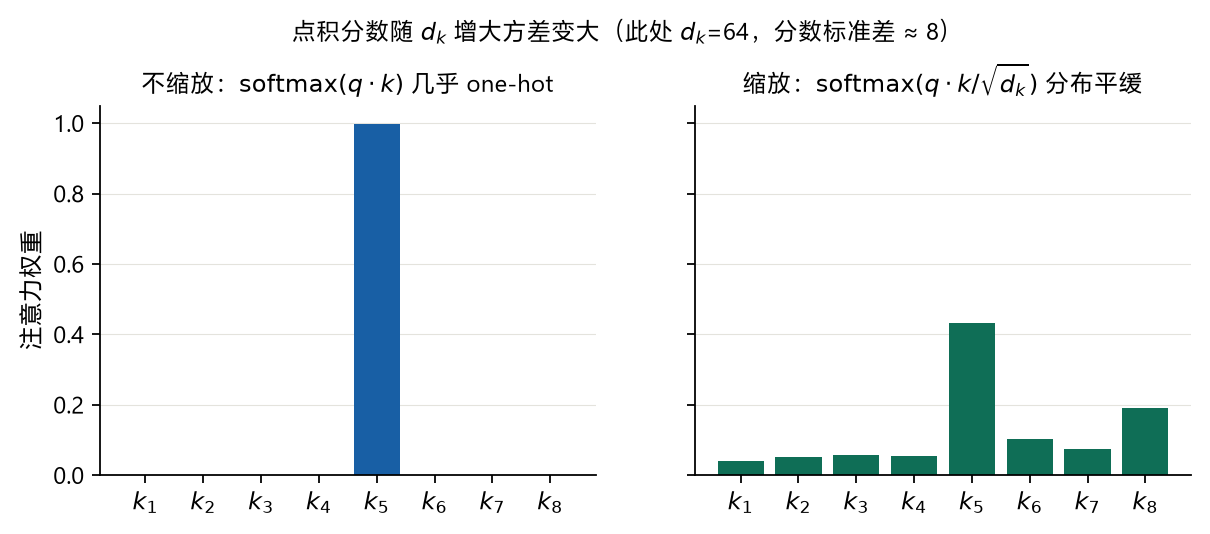
点积一大,softmax 的输出越来越接近阶跃函数——最大的一项占据几乎全部概率,其余趋近于零;
-
阶跃意味着梯度接近零 → 学习停滞。
除以键向量维度的平方根,把分数分布拉回平坦区域——这就是「缩放点积注意力」名字的由来。\(\sqrt{d_k}\) 到底改变了什么,见下图:
完整的公式为:
|
本章(也是全书)最需要警惕的一对术语:中英文都是同一个词「weight」。
前者是训练学出的参数,后者是每次前向传播实时计算的值。读论文和代码时若分不清这两个词,后续内容会难以理解。 |
两个实现细节。其一,即使只想计算一个位置的上下文向量,也需要所有位置的键和值。注意力的结构是「一个查询对全部键」,没有只算局部的捷径。其二,nn.Linear 版本(V2)与手写 x.matmul(W) 数学等价——Linear 内部按 (out, in) 存权重,相当于转置。V2 的初始化更好(kaiming),代码更短,后续实现全部采用 V2 风格:
W_query = register_module("W_query",
    torch::nn::Linear(torch::nn::LinearOptions(d_in, d_out).bias(qkv_bias)));
...
auto keys    = W_key->forward(x);      // x.matmul(W.weight.t()) + b
一个便捷的验证方法:把 V2 的权重转置后赋给 V1,两版输出逐位一致(main.cpp 中包含这次对照的输出)。
3.4 因果掩码:屏蔽未来位置
前面的注意力允许每个词元访问全部位置,包括排在它后面的位置。对语言模型来说,这不可接受。
语言模型的任务是根据前文预测下一个词。预测第 6 个词元时,第 6 个词元还不存在——看不到它,是任务本身的规则。训练时如果模型能通过注意力看到右移一位的标签(即答案),每个位置的「下一词预测」都失去训练意义。因此必须加一条规则:位置 i 只准关注 \(\le i\) 的位置。这就是因果掩码。
两种等价实现,main.cpp 各演示一遍:
// 做法 A(直观):softmax 之后乘下三角掩码,再重新行归一化
auto mask_simple = torch::tril(torch::ones({n, n}, inputs.options()));
auto masked_simple = attn_weights * mask_simple;
auto row_sums = masked_simple.sum(-1, /*keepdim=*/true);
auto masked_simple_norm = masked_simple / row_sums;

// 做法 B(标准,效率更高):softmax 之前把未来位置填 -inf,softmax 后正好为 0
auto mask = torch::triu(torch::ones({n, n}, inputs.options()), /*diagonal=*/1);
auto masked = attn_scores.masked_fill(mask.to(torch::kBool),
                                      -std::numeric_limits<double>::infinity());
auto attn_weights_inf = torch::softmax(masked / sqrt_d_k, -1);
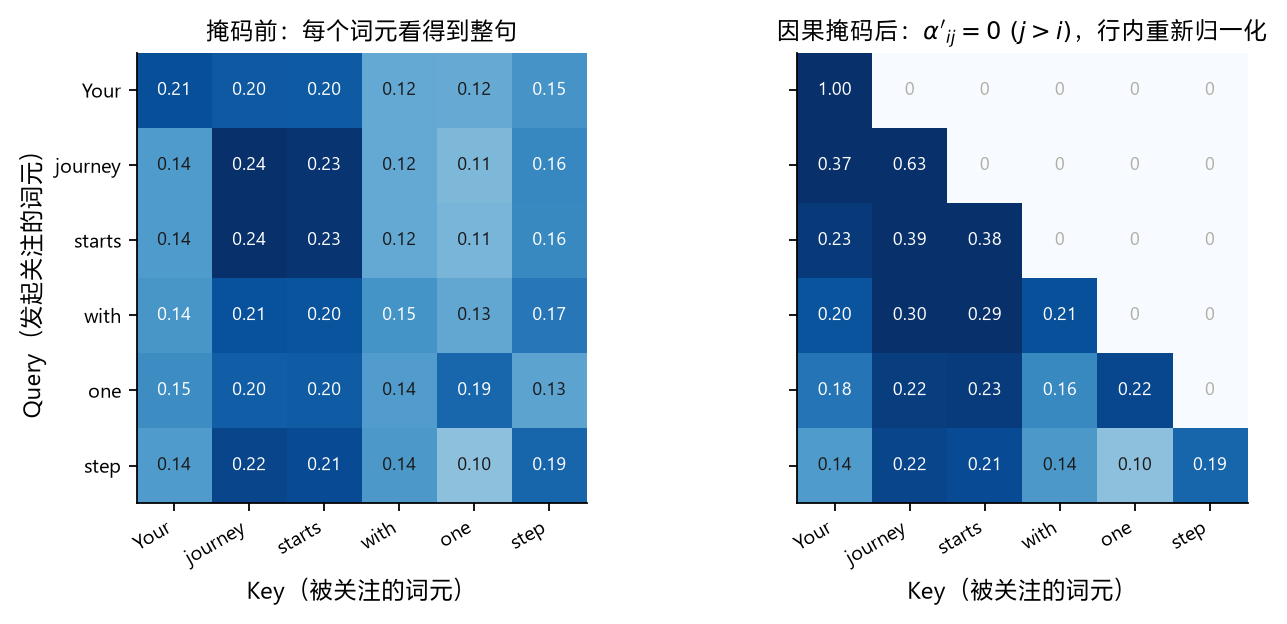
mask (triu, diagonal=1): 掩码后的注意力权重(每行和仍为 1):
0 1 1 1 1 1 1.0000 0 0 0 0 0
0 0 1 1 1 1 0.5597 0.4403 0 0 0 0
0 0 0 1 1 1 0.4791 0.3488 0.1721 0 0 0
0 0 0 0 1 1 0.4077 0.4516 0.0802 0.0605 0 0
0 0 0 0 0 1 0.3590 0.3619 0.1749 0.0570 0.0472 0
0 0 0 0 0 0 0.3810 0.2783 0.1337 0.0709 0.0587 0.0774两种做法结果一致,但推荐做法 B。softmax 遇到 −∞ 输出零概率(\(e^{-\infty} \to 0\)),分母中对应项也是 0,每行和自动为 1。重新归一化一步可以省去。函数速查:tril 是下三角(含对角线);triu(…, diagonal=1) 是上三角(不含对角线)——diagonal 参数写错会把当前位置也掩掉,模型连自己都看不见。
|
「先算 softmax 再掩码」会泄露未来信息吗? 做法 A 中,未来词元的分数参与过 softmax 分母,它们会不会通过归一化影响当前词元? 不会。 原因有三:掩码后重新归一化,实际是对剩下的子集重新做一遍 softmax;softmax 的数学性质保证掩掉的位置不产生任何影响;最终分布等价于一开始就只在允许的位置上算 softmax。信息隔离是严格的。 |
注意对角线:位置 1 的注意力 100% 在自己身上——它只能看见自己。这也解释了为什么训练时一次前向就能同时计算「每个位置的下一词预测」:第 2 章的 x/y 滑窗配合掩码,一次前向贡献 L 个监督信号。
CausalAttention 把以上内容封装进一个类,并增加两件事:dropout 和 batch 支持。掩码用 register_buffer 注册(常量:不参与训练、不求梯度,但随模型迁移到 GPU),按 num_tokens 切片以适配不同长度:
mask_ = register_buffer("mask",
    torch::triu(torch::ones({context_length, context_length}), 1));
...
attn_scores = queries.matmul(keys.transpose(1, 2));      // (b, n, n)
attn_scores = attn_scores.masked_fill(mask_bool, -inf);
attn_weights = torch::softmax(attn_scores / std::sqrt(keys.size(-1)), -1);
attn_weights = dropout_->forward(attn_weights);
return attn_weights.matmul(values);验证:torch::stack({inputs, inputs}, 0) 组成 (2, 6, 3) 的 batch,CausalAttention(d_in=3, d_out=2, dropout=0.0) 输出 (2, 6, 2)。
|
dropout 的缩放补偿机制:丢掉一部分权重后,存活元素按 \(\frac{1}{1-p}\) 放大,保证期望不变——p=0.5 时留下的元素放大一倍。没有这个补偿,训练和推理时注意力的整体强度会不一致。dropout 只在训练期工作, |
3.5 多头注意力
到上一节为止,实现的都是「单头」注意力:一组 Q/K/V 完成全部计算。单头有一个先天局限——一组投影只能捕捉一种关系模式。语法关系、语义关联、位置结构是不同类型的关系,一组投影难以同时覆盖。
多头的主要思想:并行运行多组注意力,每组用不同的线性投影,让模型能同时在多个表示子空间里关注不同位置。类比:读一份长报告,一个人只能按自己的关注点读;多人各盯一个维度再汇总,覆盖的信息面更宽。
数学形式——每个头在自己的投影子空间里做注意力,最后拼接并经输出投影 \(W_O\) 混合:
包装器版实现
// 堆叠 H 个独立的 CausalAttention,各自 forward 后拼接
for (const auto& h : heads_) outs.push_back(h->forward(x));
return torch::cat(outs, -1);
d_out=2、num_heads=2 时输出 (2, 6, 4)——每个头贡献 2 维,输出维度变多。这种写法定义清晰,但有两个代价:逐头顺序执行,所谓「并行」只是逻辑上的并行;每个头各自做一遍 Q/K/V 投影——矩阵乘法是计算开销最大的操作之一,头数一多,重复计算的代价显著。
高效版实现:GPT-2 采用的方式
换一个思路:不做 H 套投影,只做一次投影,把结果切成 H 份,每份当作一个头。整条形状链如下:

class MultiHeadAttentionImpl : public torch::nn::Module {
public:
    MultiHeadAttentionImpl(int64_t d_in, int64_t d_out, int64_t context_length,
                           double dropout, int64_t num_heads, bool qkv_bias = false)
        : d_out_(d_out), num_heads_(num_heads), head_dim_(d_out / num_heads) {
        TORCH_CHECK(d_out % num_heads == 0, "d_out must be divisible by num_heads");
        W_query = register_module("W_query", Linear(d_in, d_out).bias(qkv_bias));
        W_key   = register_module("W_key",   Linear(d_in, d_out).bias(qkv_bias));
        W_value = register_module("W_value", Linear(d_in, d_out).bias(qkv_bias));
        out_proj = register_module("out_proj", torch::nn::Linear(d_out, d_out));
        dropout_ = register_module("dropout", torch::nn::Dropout(dropout));
        mask_    = register_buffer("mask", triu(ones({context_length, context_length}), 1));
    }
    torch::Tensor forward(torch::Tensor x) {
        auto keys = W_key->forward(x), queries = W_query->forward(x),
             values = W_value->forward(x);                       // (b, T, d_out)
        // 切头:(b, T, H, d_h) -> (b, H, T, d_h)
        keys    = keys.view({b, T, num_heads_, head_dim_}).transpose(1, 2);
        queries = queries.view({b, T, num_heads_, head_dim_}).transpose(1, 2);
        values  = values.view({b, T, num_heads_, head_dim_}).transpose(1, 2);

        auto attn_scores = queries.matmul(keys.transpose(2, 3));  // (b, H, T, T)
        attn_scores = attn_scores.masked_fill(mask_bool, -inf);
        auto attn_weights = torch::softmax(
            attn_scores / std::sqrt(keys.size(-1)), -1);          // 注意:√head_dim
        attn_weights = dropout_->forward(attn_weights);

        auto context_vec = attn_weights.matmul(values)
                               .transpose(1, 2)                   // (b, T, H, d_h)
                               .contiguous().view({b, T, d_out_});
        return out_proj->forward(context_vec);
    }
    ...
};|
两种多头实现,参数相同,输出形状却不同——原因是「多头」有两种语义:
Wrapper 是拼接多个独立头的输出( |
3.6 高效版的三个易错点
高效版有三个易错点,出错时现象各异,排查都不轻松。提前过一遍,遇到问题时可以更快定位。
易错点一:缩放分母变了。 包装器版中,每个头是独立的注意力,键向量维度是完整的 d_out;高效版把总维度切成 H 份,每个头的键只有 head_dim = d_out/H 维。缩放分母必须相应变成 \(\sqrt{\mathrm{head\_dim}}\)——点积的量级由参与运算的维度决定。GPT-2 small:768 维、12 头,head_dim = 64,除的是 \(\sqrt{64} = 8\)。
易错点二:transpose 之后,view 会报错。 transpose 只改维度的解读方式,不动内存布局——新形状下内存不连续,而 view 要求连续内存。标准写法是 contiguous().view(…):先把内存整理成连续的,再改形状。因果链:transpose 改解读 → 内存不连续 → view 拒绝 → contiguous 补救。
易错点三:合并之后还要过 out_proj。 各头在自己的子空间里独立计算,拼接的结果只是各头输出的并排摆放,头与头之间还没有信息交互——out_proj 让模型学习怎么组合这些视角。这一层是高效版独有的,包装器版没有。漏写它,输出形状正确、数值不对,训练曲线异常,排查困难。
底层原理是批矩阵乘法:queries.matmul(keys.transpose(2, 3)) 时,框架在最后两个维度之间做矩阵乘法,前面的维度(batch、head)当作批处理索引——等价于逐头循环,但一次调用完成 H 个头的计算。这也解释了切头时为什么要用 transpose 把 H 提到序列维前面:让「头」成为批索引、让 (T, d_h) 恰好落在最后两维。
GPT-2 规模验证(练习 3.3):d_in=d_out=768、num_heads=12、context_length=1024,输入 [2, 8, 768],输出 [2, 8, 768]——输出形状与输入一致。维度不变、内容重编码,这正是第 4 章「Transformer 块可以无限堆叠」的前提。可学习参数张量共 5 组(Q/K/V 三份无偏置权重 + out_proj 的权重与偏置)。
3.7 编译运行与预期输出
./scripts/run.sh chapter03_attention输出按演示序号顺序排列(3.3.1 → 3.3.2 → 3.4.1 → 3.4.2 → 3.5.1 → 3.5.2 → 3.5.3 → 3.6.1 → 3.6.2;编号为程序内的演示序号,与本章小节号略有错位)。下面摘录部分确定性输出,可与你的运行结果逐位核对:
3.3.1: attn_scores_2 = [0.9544, 1.4950, 1.4754, 0.8438, 0.7070, 1.0865]
       attn_weights_2 = [0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581]
       context_vec_2 = [0.4419, 0.6515, 0.5683]
3.5.1: 掩码后每行和 = 1,上三角全 0
3.5.2: dropout(ones) 元素非 0 即 2.0
3.5.3: batch.shape = [2, 6, 3] → context_vecs.shape = [2, 6, 2]
3.6.1: context_vecs.shape = [2, 6, 4];[练习 3.2] d_out=1 → [2, 6, 2]
3.6.2: [练习 3.3] 输入 [2, 8, 768] -> 输出 [2, 8, 768]
3.4.2: [练习 3.1] v1 赋 v2 权重后两版输出逐位一致
3.8 术语速查表
| 术语 | 一句话定义 |
|---|---|
上下文向量 |
融合了序列中所有元素信息的嵌入向量 \(z^{(i)}\) |
注意力分数 ω |
查询与键的点积(未归一化) |
注意力权重 α |
注意力分数经 softmax 归一化后的值,和为 1 |
查询/键/值 |
借自信息检索:正在寻找的信息 / 可供检索的标签 / 实际提供的内容 |
缩放点积注意力 |
除以 \(\sqrt{d_k}\) 后再 softmax 的自注意力 |
权重参数 vs 注意力权重 |
训练学出的投影矩阵 vs 每次前向实时计算的注意力分配 |
因果/掩码注意力 |
屏蔽未来词元的自注意力(−∞ 法每行和自动为 1) |
register_buffer |
随模型自动在 CPU/GPU 间迁移的非参数张量(本教程用它存放掩码) |
头维度 head_dim |
|
批处理矩阵乘法 |
最后两维做乘法、对每个头重复——多头「并行」的实现基础 |
本章小结
-
注意力机制的由来:RNN 把全句压缩成固定向量,信息随句子变长而丢失。先有 Bahdanau 注意力让解码器回看全部源位置,再有自注意力彻底移除 RNN 结构。
-
简单自注意力三步:点积计算相关度(利用嵌入的语义编码)→ softmax 归一化权重(稳定、可导、可解释)→ 加权求和得到上下文向量。矩阵化形式是后续所有实现的雏形。
-
可训练自注意力:Q/K/V 使注意力从固定机制变成可学习行为(信息检索类比);\(\sqrt{d_k}\) 防止大维度点积把 softmax 推入梯度饱和区;「权重参数 vs 注意力权重」是中英文同形、必须区分的术语。
-
因果掩码:把「不能看未来」翻译成矩阵操作——填 −∞ 使未来位置权重为零、每行之和自动归一、数学上不泄露未来信息;dropout 靠缩放补偿保证训练与推理一致。
-
多头注意力:多组投影并行。包装器版直观但计算重复;高效版(一次投影 + 切分 + 批矩阵乘 + 合并 + out_proj)是 GPT-2 实际采用的实现。三个易错点:\(\sqrt{\mathrm{head\_dim}}\)、contiguous+view、out_proj。
自测清单
能不回看就答出这些,本章就算过关:
-
程序段 3.3.1 的三个输出,与 3.7 节的确定性输出逐位一致
-
能用单位向量解释「点积为什么适合衡量相似度」
-
能完整复述缩放推理链(维度大 → 点积大 → softmax 阶跃化 → 梯度消失)
-
能区分权重参数与注意力权重(中英文都是 weight)
-
掩码后注意力权重每行和为 1,且上三角为 0
-
能解释「先 softmax 再掩码再归一化」为什么不存在信息泄露
-
理解为什么缩放分母是 \(\sqrt{\mathrm{head\_dim}}\) 而不是 \(\sqrt{d_{\mathrm{out}}}\)
-
能说清
contiguous().view()的因果链(transpose 后不能直接 view) -
能说出包装器版与高效版的三点差异(out_proj、head_dim 缩放、计算重复)
-
高效版输出
[2, 6, 2](d_out=2, H=2);GPT-2 规模下输出形状与输入一致
习题
-
把
num_heads从 12 改成 8、16(改demo_mha_weight_split里 GPT-2 规模 那段并重编译),验证head_dim相应变为 96、48,输出形状不变。 -
把
CausalAttention的 dropout 设为 0.5,观察context_vecs的数值变化; 再执行eval(),确认 dropout 已关闭(第 0 章 train/eval 约定的实操)。 -
推导
d_out=1, num_heads=2的包装器输出为什么是[2, 6, 2]而不是[2, 6, 4]。 -
把高效版的
out_proj注释掉重跑,观察输出数值变化, 用数字说明 out_proj 组合各头输出的作用。
拓展阅读
-
seq2seq 固定向量瓶颈(Sutskever et al., 2014): https://arxiv.org/abs/1409.3215
-
Bahdanau 注意力(Bahdanau et al., ICLR 2015): https://arxiv.org/abs/1409.0473
-
Transformer 与缩放点积/多头出处(Vaswani et al., 2017): https://arxiv.org/abs/1706.03762
-
dropout 缩放补偿(Srivastava et al., JMLR 2014): https://jmlr.org/papers/v15/srivastava14a.html
-
GPT-2 论文(12 头 × 768 维规格): https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf