第 5 章 预训练:从随机权重到连贯文本
|
本章导读:给第 4 章的模型补上损失函数、训练循环与解码策略三块组件, 完整跑一遍从随机初始化到生成连贯文本的流程,最后加载 OpenAI 官方权重, 验证整条实现链路的正确性。 学完本章你将能够:
产出与代码: |
5.1 无标签数据的自回归训练
预训练不需要人工标注数据。标签由数据自身提供:把输入右移一位,标签就
出来了——"every effort moves" 的预测目标是 " effort moves you"。
这个设定叫自回归:模型的任务永远是「预测下一个词元」。语言本身就是
「下一个词接什么」的序列,监督信号与数据的天然形态重合,因此免费且
无限。
本章的五步流水线:

这个任务有一个可以直接算出来的起点:随机初始化的模型在 50257 个词元里 猜下一个,猜中正确词元的概率是多少?概率质量分散在 5 万词表上,答案从 数学上就能得出。两个数字贯穿全章,先记住:
-
地板 loss = \(\ln(V) \approx 10.82\):未训练模型对正确词元的概率约 1/50257, \(-\log(1/V) = \ln(V) \approx 10.82\)。这是所有训练的起点,也是能从数学上算出来 的起跑线;
-
困惑度 \(\mathrm{PPL} = \exp(\mathrm{loss})\):loss 为 10.82 时,PPL ≈ 5 万——模型在约 5 万个词元里犹豫不决;loss 降到 1.7 时,PPL ≈ 5.5——候选范围已经 收窄。
这个起跑线在本章后面会反复出现。它还有一个实用用途:检验数据管道 有没有 bug。
5.2 手算交叉熵与困惑度
未训练模型算出的第一个 loss 是 10.79。这个数是好是坏,要先弄清它的 计算过程。本节在 2×3 的小批次上把交叉熵手推一遍,再引入困惑度。
手算一遍交叉熵
以下代码(src/main.cpp 的 demo_loss)构造一个 2×3 的小批次,
targets 是各自右移一位的结果:
// inputs 两句话,targets 是各自右移一位的结果
auto inputs  = torch::tensor({{16833L, 3626L, 6100L},   // "every effort moves"
                              {40L,    1107L,  588L}},  // "I really like"
                             torch::kLong);
auto targets = torch::tensor({{3626L, 6100L,  345L},    // " effort moves you"
                              {1107L,  588L, 11311L}},  // " really like chocolate"
                             torch::kLong);
前向 → softmax → 取目标词元概率 → 取对数 → 求均值 → 取负,得到平均对数 概率的负值——这正是交叉熵的定义。其中三步值得单独说明:
-
为什么取目标词元的概率:未训练模型对正确词元的概率约
1/50257 ≈ 2e-5(初始随机权重把概率质量分散在 5 万词表上)——模型「猜中」目标词的概率, 就是衡量它离学会语言有多远的标尺; -
为什么取对数:概率的对数比概率本身更容易操作——连乘变连加, 数值范围压缩;
-
为什么取负:优化的惯例不是「把平均对数概率升到 0」,而是 「把负平均对数概率降到 0」——这个负平均对数概率就叫交叉熵损失, 它衡量两个概率分布的差异:数据集词元的真实分布 vs 模型的预测分布。 实践中「交叉熵」与「负平均对数概率」经常互换使用。
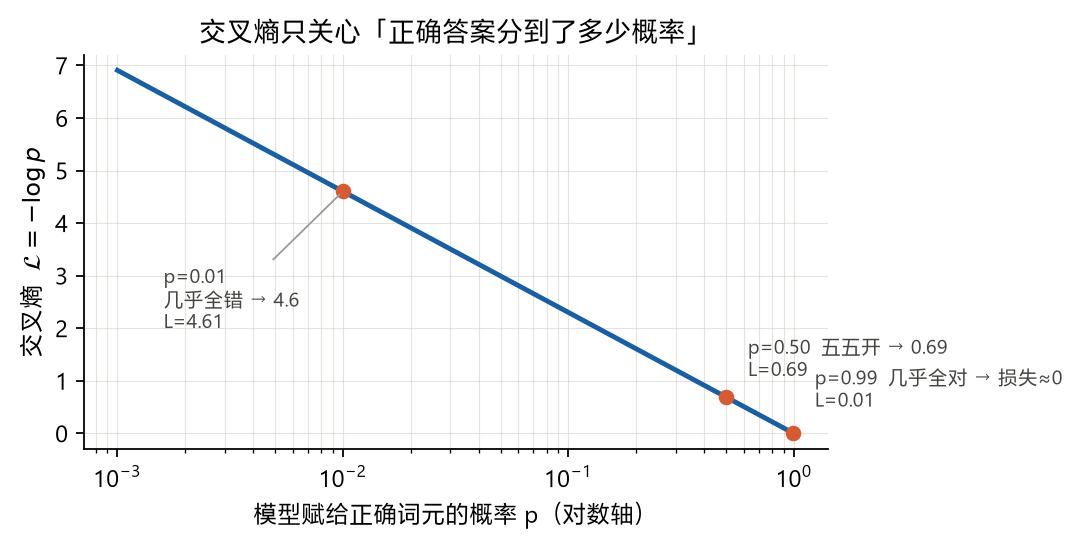
六步可以浓缩成一条公式:对批次内每个位置上目标词元的对数概率取负, 再求均值。
这条公式对概率的惩罚不是线性的:模型把正确答案的概率压得越低, 损失涨得越狠,在对数轴下尤其直观。
C++ 里取「目标位置的概率」的固定写法是先按 batch 维索引,再取对角线:
auto probas = torch::softmax(logits, -1);               // (2, 3, 50257)
// probas[0, :, [3626, 6100, 345]] 后取 diagonal —— 每个位置上目标词元的概率
auto target_probas_1 = probas
    .index({0, torch::indexing::Slice(),
            torch::tensor({3626L, 6100L, 345L})})
    .diagonal();
auto log_probas = torch::log(torch::cat({target_probas_1, target_probas_2}));
auto neg_avg = torch::mean(log_probas) * -1; // 手工交叉熵生产代码直接用内置交叉熵,一步到位且数值更稳。calc_loss_batch 是
全章最核心的函数(include/training.h):
inline torch::Tensor calc_loss_batch(const torch::Tensor& input_batch,
                                     const torch::Tensor& target_batch,
                                     ch4::GPTModel& model) {
    auto logits = model->forward(input_batch);
    auto loss = torch::nn::functional::cross_entropy(
        logits.flatten(0, 1),          // (batch*seq, vocab)
        target_batch.to(logits.device()).flatten());
    return loss;
}
flatten(0, 1) 把 (batch, seq, vocab) 展平成 (batch*seq, vocab),每个
位置的预测于是都变成一个独立的 50257 分类问题。这一步必须做:内置
交叉熵要求 logits 形如 [N, C]、targets 形如 [N],三维张量直接喂
进去会报形状错误。
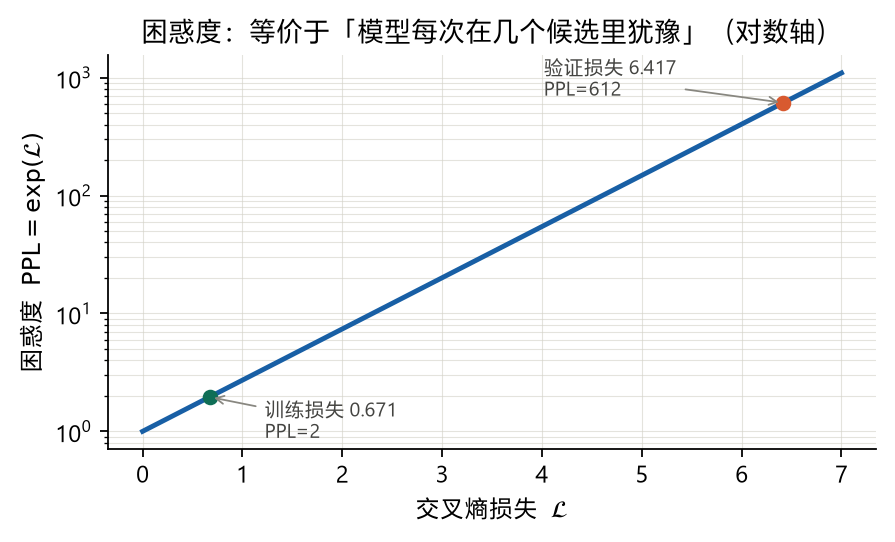
对损失再作一层解读,得到困惑度(perplexity)= \(\exp(\mathrm{loss})\):直觉上, 它是模型在每一步对多少个词元感到「不确定」。初始损失 10.79 对应困惑度 48,726——模型相当于在 4.9 万个词元里做选择。困惑度比原始损失更易于 解读:loss 从 10.79 降到 3.0 没有直观感受,困惑度从 48,726 降到 20 则一目了然。
exp 曲线的形状决定了读法:损失在高端每降一点,困惑度塌得飞快;到了 低端(损失 < 1)再往下压就越来越费劲。解读时先看损失落在曲线哪一段, 再评估困惑度变化的幅度:
遍历整个 DataLoader 求平均损失
calc_loss_loader 把单批次损失扩展到整个数据集:torch::NoGradGuard
关闭梯度,model→eval() 切换评估模式,计算完用 model→train()
切回来:
inline double calc_loss_loader(ch4::GPTModel& model,
                               const std::vector<ch2::GPTBatch>& loader,
                               c10::optional<int64_t> num_batches = c10::nullopt) {
    torch::NoGradGuard no_grad;
    model->eval();
    for (int64_t i = 0; i < n; ++i) {
        total_loss += calc_loss_batch(loader[i].inputs, loader[i].targets,
                                      model).item<double>();
    }
    model->train();                       // 评估完切回训练模式
    return total_loss / n;
}对随机初始化的模型实测(demo_dataset_loss):The Verdict 在文本上按
90/10 切分训练/验证集、两侧各自分词(4612 / 534 个词元,边界词元被切开,
合计比全文的 5145 多 1);初始损失 train 10.99 / val 10.98,略高于地板
ln(50257)=10.82——随机初始化的 logits 并非均匀分布,平均交叉熵本来就会
比 \(\ln V\) 略高。量级对得上,说明数据管道没有 bug。 数值核对在后面的
章节会反复用到:理论上能算出来的数,实测必须对上;对不上就是代码
有问题。
两个 DataLoader 的配置并不对称,每一处差异都有原因:
| 参数 | 训练集 | 验证集 | 差异原因 |
|---|---|---|---|
|
true |
false |
训练要打乱;验证要保持顺序(可复现) |
|
true |
false |
训练丢弃不足一批的尾巴;验证集保留全部数据 |
|
2 |
2 |
数据集太小,用小批次减少计算需求 |
规律:训练侧的所有配置都为「梯度质量」服务,验证侧的所有配置都为 「可比性」服务。同一份数据,两种读法。
本章还把 context_length 从第 4 章的 1024 临时改为 256,减少计算量
让笔记本能跑完训练;5.6 节加载官方权重时再改回 1024。
5.3 五步训练循环与 AdamW
第 0 章 §H 的五步模板,在这里实现为完整的训练循环。完整的 PyTorch
训练循环是 8 步(epoch → batch → zero_grad → loss → backward → step →
评估监控 → 生成样本监控),核心计算只占前 6 步。下面的
train_model_simple 是任何 LLM 训练的最小骨架(include/training.h):
inline void train_model_simple(ch4::GPTModel& model,
                               const std::vector<ch2::GPTBatch>& train_loader,
                               const std::vector<ch2::GPTBatch>& val_loader,
                               torch::optim::AdamW& optimizer, int64_t num_epochs,
                               int64_t eval_freq, int64_t eval_iter,
                               const std::string& start_context,
                               ch2::BpeTokenizer& tokenizer) {
    for (int64_t epoch = 0; epoch < num_epochs; ++epoch) {
        model->train();
        for (const auto& batch : train_loader) {
            optimizer.zero_grad();                              // 1. 清梯度
            auto loss = calc_loss_batch(batch.inputs, batch.targets, model);  // 2. 前向
            loss.backward();                                    // 3. 反向传播
            optimizer.step();                                   // 4. 更新参数
            tokens_seen += batch.inputs.numel();                //    记账
            if (global_step % eval_freq == 0) {                 // 5. 定期评估
                auto [train_loss, val_loss] =
                    evaluate_model(model, train_loader, val_loader, eval_iter);
                std::cout << "Ep " << (epoch + 1) << " (Step " << global_step
                          << "): Train loss " << train_loss << ", Val loss "
                          << val_loss << "\n";
            }
        }
        generate_and_print_sample(model, tokenizer, start_context);  // 每轮末尾打印生成样本
    }
}
一个能跑通 GPT-2 预训练的循环,核心就是这五步。第 8 章加入的学习率 调度与梯度裁剪,都只是在这副骨架上扩展。
main.cpp 用 AdamW(lr=4e-4, weight_decay=0.1) 跑 10 轮:
torch::optim::AdamWOptions options(4e-4);
options.weight_decay(0.1);
auto optimizer = torch::optim::AdamW(model->parameters(), options);
为什么是 AdamW:Adam 是训练深度网络的常见选择;AdamW 是它的变体,
改进了权重衰减(weight_decay)的实现方式——通过对较大的权重施加
惩罚来控制模型复杂度、防止过拟合,正则化更有效,泛化更好。这是 LLM
训练普遍使用 AdamW 的原因。model→parameters() 返回全部可训练参数
(含 weight 与 bias),正好是优化器需要的输入。
Adam 与 AdamW 的差别值得单独说清:
|
AdamW 与 Adam 的差别究竟在哪?在 Adam 里加 L2 正则(把 \(\lambda w\) 加进梯度) 并不能等效于真正的权重衰减:Adam 的更新步长会被二阶矩估计 \(\bar{v}\) 归一化, 而 \(\bar{v}\) 恰好也包含了正则项自身——结果是梯度越大的参数受到的正则越弱, 惩罚被自适应学习率「稀释」了。AdamW 的做法是把衰减从梯度里拆出来: 更新时直接执行 \(w \leftarrow w - \eta\, \lambda\, w\),与梯度大小、\(\bar{v}\) 完全无关。一句话: L2-in-Adam 把正则强度耦合进了梯度尺度,AdamW 把两者解耦—— 这就是论文标题 "Decoupled Weight Decay Regularization" 的含义。 |
每轮结束的 generate_and_print_sample 是人工检查点:打印当前模型的
生成样本,肉眼确认训练在推进。样本的演化轨迹有明确规律——从只会
接逗号,到学会语法,最后逐字背诵原文:
Ep 1:  Every effort moves you,,,,,,,,,,,,.          ← 只会接逗号
Ep 2:  Every effort moves you, and, and, and, ...   ← 学到一点语法
Ep 9:  ...quite insensible to the irony. She wanted
       him vindicated--and by me!...                ← 背诵原文(过拟合的直接证据)
Ep 10: ...was one of the axioms he laid down across
       the Sevres and silver of an exquisitely
appointed luncheon-table... ← 逐字复现训练集|
5145 个词元训练 124M 参数的模型——过拟合是必然的,val loss 先降后升
(最终 train 0.67 / val 6.42 的分叉)不是 bug,而是这个实验的教学目的:
让你直观看到「小数据 + 大模型 = 记忆」。过拟合的直接证据是生成的
|
看到曲线分叉,先不要怀疑代码:本教程故意不做早停,让分叉和逐字复现 都出现在运行结果里。参数量是词元数的两万多倍,模型除了记忆 训练数据没有别的出路。
预训练的真实代价(为什么「加载权重」是刚需):以 Llama 2 7B 为例—— 2 万亿词元、184,320 个 A100 GPU 小时,按 8×A100 服务器 30 美元/小时计 约 69 万美元(此为按 GPU 时数折算的估算口径,官方模型卡只公布 GPU 时数)。5.6 节加载 OpenAI 权重,省下的就是这个量级的成本。教程里 从零预训练是体验流程用的;实际项目中获取模型,加载现成权重是常规做法。
5.4 解码策略:温度缩放与 Top-k 采样
贪心解码(argmax)始终选择概率最高的词元,输出缺乏多样性——第 1 章
bigram 模型的 the the the 就是这种表现。要控制生成的随机性,需要
两个参数:温度与 Top-k。
温度缩放:把 logits 除以 T
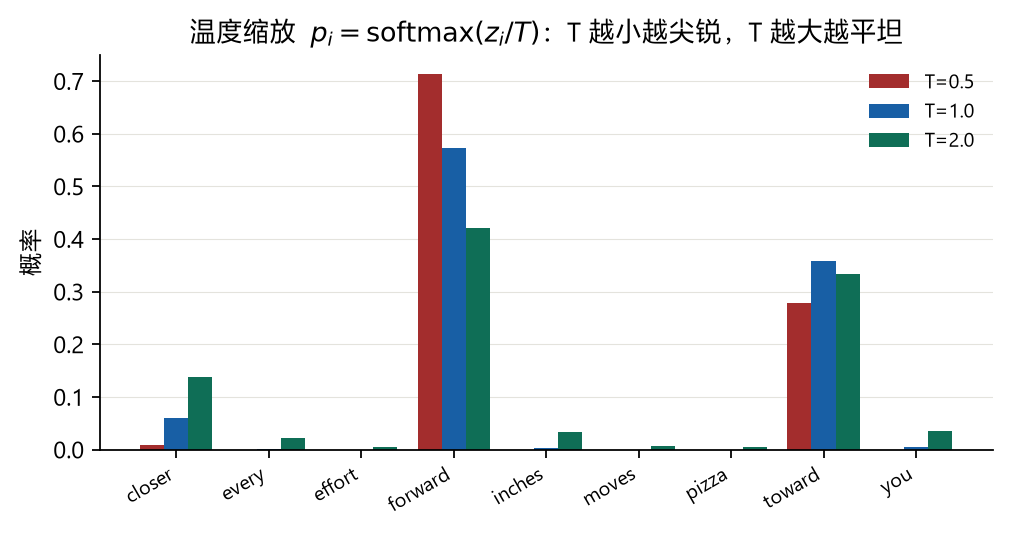
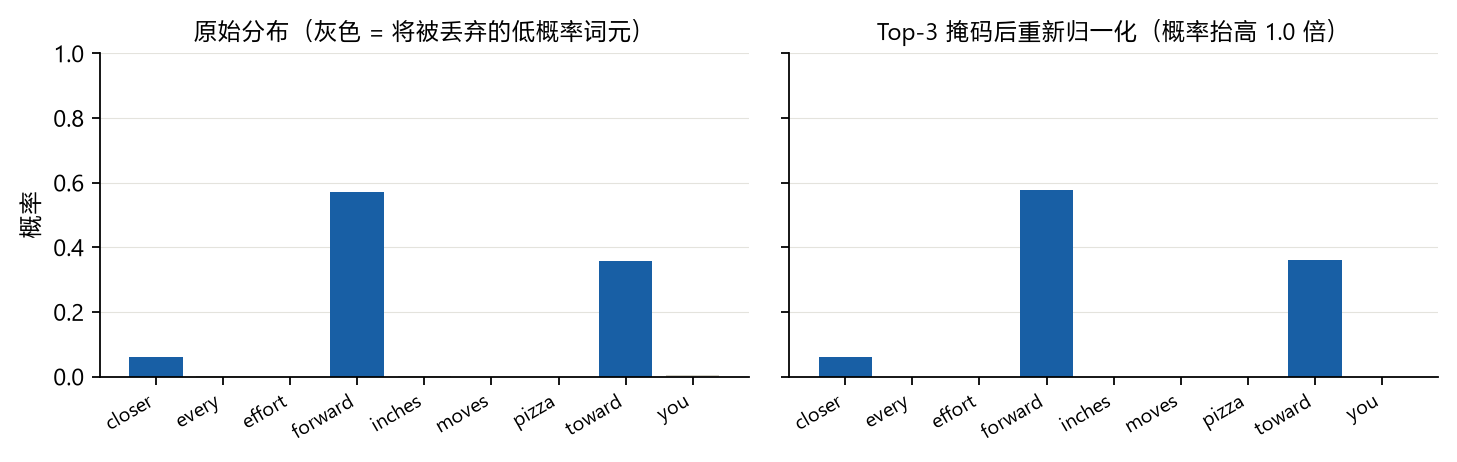
用 9 词迷你词表做实验(demo_decode_strategies):
auto next_token_logits = torch::tensor(
    {4.51, 0.89, -1.90, 6.75, 1.63, -1.62, -1.89, 6.28, 1.79});
//        closer every effort forward inches moves pizza toward you
multinomial 按原始概率采样 1000 次的分布,与三种温度下的概率对比:
multinomial 采样 1000 次:  582 x forward, 343 x toward, 73 x closer, 2 x inches
T=1.0   P(forward)=0.5721   P(pizza)=0.0001   // 原始分布
T=0.1   P(forward)=0.9910   P(pizza)=0.0000   // 趋近 one-hot,确定性强
T=5.0   P(forward)=0.2421   P(pizza)=0.0454   // 趋近均匀,"pizza"也有机会
multinomial 替代 argmax 是概率采样:forward 仍是最可能的词元,大多数 (但不是每次)被选中——582/1000 = 58.2% 与真实概率 57.2% 吻合, 大数定律的现场演示。温度参数的三条结论:
-
T = 1 相当于不做温度缩放(除以 1 就是原始 softmax);
-
T < 1 → 分布更集中 → multinomial 几乎 100% 选最可能词元 → 接近 argmax 行为;
-
T > 1 → 分布更均匀 → 增加变化,但更容易生成无意义文本 (T=5 时约 4.5% 概率生成 "every effort moves you pizza")。
概括成一句:温度低,分布尖锐,输出稳定但单调;温度高,分布平坦, 输出多样但更容易不连贯。
公式只有一行——除以 T 再 softmax,T=1 退化为原始分布:
把实测表画出来,三种温度对同一组 logits 的重塑一目了然:
Top-k:先截断再采样
温度控制分布形状,Top-k 控制候选范围:把候选限制在概率最高的 k 个
词元里,其余置 −∞(include/training.h 的 generate):
if (top_k.has_value()) {
    auto top_values = std::get<0>(torch::topk(logits, k));
    auto threshold  = top_values.narrow(1, k - 1, 1);      // 第 k 大的值
    logits = torch::where(logits < threshold,
                          torch::full_like(logits, -std::numeric_limits<double>::infinity()),
                          logits);
}
torch::Tensor idx_next;
if (temperature > 0.0) {                                   // 温度采样
    auto probs = torch::softmax(logits / temperature, -1);
    idx_next = torch::multinomial(probs, 1);
} else {                                                   // 贪心
    idx_next = torch::argmax(logits, -1, /*keepdim=*/true);
}
if (eos_id.has_value() && idx_next.item<int64_t>() == eos_id.value()) break;
温度与 Top-k 组合使用:先截断(控上限),再按温度采样(控形状)。
eos_id 让模型自己输出结束符——第 6/7 章微调后会用到。Top-k 的公式
与因果掩码同构:k 名之外的 logit 全部置 −∞,softmax 后概率自动归零、
剩余项自动重新归一化。第 3 章的因果注意力掩码用的正是同一个机制:
|
两个跨章呼应与一个踩坑点:
|
贪心与采样的实际对比(训练后的 124M 模型):贪心解码给出的是
训练集中被逐字记住的段落("was one of the axioms he laid down…");
top_k=25, temperature=1.4 生成全新的、未被记忆的文本
("stand to work on surprise, a one of us had gone with random-")。
解码策略的意义:减少记忆、增加独创性。
调试生成效果时的对应关系:输出过于单调,提高温度或增大 k;输出容易 不连贯,反向调整。四个组件各管一段——温度控制分布形状,Top-k 控制 候选范围,multinomial 执行采样,eos_id 提前终止。
5.5 保存与加载权重
训练完成的模型应当保存,避免每次使用都重新训练。LibTorch 的保存与 加载各用一行:
torch::save(model, dir + "/model.pth");       // 整个模型(含 state_dict)
ch4::GPTConfig cfg;
cfg.context_length = 256;                     // 必须与训练时一致
ch4::GPTModel model2(cfg);
torch::load(model2, dir + "/model.pth");
注意 cfg.context_length 必须与训练时一致,否则权重形状对不上或行为
异常。加载到新实例后,与原模型对同一提示各生成 5 个词元,
t1.equal(t2) 输出 yes——权重往返无损。model.pth 约 622 MB
(163,009,536 个参数 × 4 字节)。动机很直接:预训练代价高昂,保存
权重才能避免重复训练。
只保存模型权重并不完整。AdamW 这类自适应优化器会为每个参数维护额外 状态,续训时必须一并恢复:
|
为什么保存优化器状态也很重要:AdamW 这类自适应优化器为每个模型权重
存储额外的参数(动量等),用历史数据动态调整每个参数的有效学习率。
如果不保存,优化器重置,续训可能效果不佳甚至无法正确收敛——
续训后的模型可能失去生成连贯文本的能力。Python 的标准做法是把
|
保存的复杂度不在 IO,而在恢复目标:推理只需要权重,续训还需要 优化器状态。C++ 侧另有一个平台限制:
|
C++ 版 |
5.6 加载 OpenAI 预训练权重
这一步是本章的综合检验:把 HuggingFace 版 GPT-2 权重(与 OpenAI 原版
同数值)装进第 4 章手写的 GPTModel,生成连贯英文。工程拆成三层:
格式解析、键名映射、形状翻转。
safetensors 格式解析
第一层是格式解析。include/safetensors.h 实现了一个 60 行的解析器,
格式只有三段:
[8 字节 uint64 LE]  header 长度 N
[N 字节 JSON]       {"wte.weight": {"dtype":"F32","shape":[50257,768],
                                      "data_offsets":[0,154389504]}, ...}
[数据区] 各张量按 data_offsets 连续存放(float32, row-major)不需要任何第三方库:std::ifstream 读进来,torch::from_blob 包一下
就是张量。
键名映射 + 形状翻转
真正的难点在第二、三层:两边的参数命名不一致,需要一张映射表
(src/main.cpp 的 map_key):
| 我们的 GPTModel | HuggingFace gpt2 | 形状处理 |
|---|---|---|
|
|
同形 [50257,768] |
|
|
同形 [1024,768] |
|
|
split 成 3 份 + 转置 |
|
|
转置 |
|
|
转置 |
|
|
同形 [768] |
|
|
weight tying,再赋一次 |
最关键的形状翻转:HF 的 GPT-2 用 Conv1D,权重存成 [in, 3*emb]——
Q/K/V 三合一;我们的 nn::Linear 权重是 [out, in]。所以要先按
最后一维切成三份、再各自转置:
auto c_attn_w = params("blocks." + std::to_string(b) + ".attn.c_attn.w");
auto split = c_attn_w.split(cfg.emb_dim, /*dim=*/1);        // [in,emb] × 3
block.att->W_query->weight =
    assign(block.att->W_query->weight, split[0].t().contiguous());
block.att->W_key->weight =
    assign(block.att->W_key->weight, split[1].t().contiguous());
block.att->W_value->weight =
    assign(block.att->W_value->weight, split[2].t().contiguous());
整套装载的可靠性依赖一个叫 assign 的小工具:形状不匹配立刻抛异常,
且必须在 NoGradGuard 下 copy_(参数是 requires_grad 的叶子张量,
直接赋值会报错,等价 Python 的
with torch.no_grad(): param.copy_(…)):
auto assign = [](torch::Tensor left, const torch::Tensor& right) {
    if (left.sizes() != right.sizes())
        throw std::runtime_error("Shape mismatch");
    { torch::NoGradGuard g; left.copy_(right); }
    return left;
};
它防的是静默失败:形状不匹配却不报错时,模型照常运行、输出错误结果, 排查难度远高于直接崩溃。装载代码的原则:让失败显式、尽早地暴露。
加载时切换到 OpenAI 原生配置:context_length = 1024、
qkv_bias = true。第 4 章的 GPTConfig 提供这两个开关,此处取 OpenAI
原生值:不改前者,位置嵌入会越界;不改后者,权重里多出来的偏置没有
地方放。最后 out_head→weight = assign(…, params("wte")) 完成
weight tying——输出层与词嵌入共享同一份权重,显式还原第 4 章参数
核算时讨论的那份共享。
5.7 编译运行与预期输出
./scripts/run.sh chapter05_pretraining           # 默认 10 轮训练
./scripts/run.sh chapter05_pretraining 0         # epochs=0:跳过训练,只做评估/解码/加载
数据目录默认 data/(the-verdict.txt + encoder.json + vocab.bpe
gpt2-model.hf.safetensors,均由第 0 章脚本自动下载)。关键输出(节号为程序内的演示序号,与本章小节号略有错位):
=== 5.1.2 计算文本生成损失
Loss (cross_entropy): 10.79
Perplexity: 48726

=== 5.1.3 计算训练集和验证集的损失
train_data tokens: 4612, val_data tokens: 534
Train loader batches: 9
Training loss: 10.99
Validation loss: 10.98          ← 略高于地板 ln(50257)≈10.82(随机 logits 非均匀所致)

=== 5.2 训练大语言模型
Ep 1 (Step 0): Train loss 9.72, Val loss 10.02
...(train 一路下降,val 先降后升)
train 范围 9.72 → 0.67,val 范围 10.02 → 6.42
Every effort moves you as Herm the one of the axioms he laid down...   ← 每轮末尾的生成样本人工检查

=== 5.4 保存与加载
已保存模型权重到 data/model.pth(约 622 MB)
加载后生成与训练模型一致: yes

=== 5.5 从 OpenAI 加载预训练权重
Output text:
 Every effort moves you toward finding an ideal new way to practice ...
注:训练轮数与显存不同会导致 loss 曲线细节略有差异,但 「起点 ≈ 11、train 降到 1 以内、val 反弹到 6–7」的形态应当一致。
生成出连贯英文,加载正确性就有了最终检验。整个装载过程由五部分组成: 格式解析(60 行)、键名映射(一张表)、形状翻转(split + 转置)、 配置切换(两处)、assign 形状校验(不匹配立即抛错)。
本章小结
-
交叉熵(负平均对数概率)衡量预测分布与真实分布的差异;困惑度 \(\exp(\mathrm{loss})\) 是更直观的等价表述;未训练模型的 loss ≈ ln(50257) ≈ 10.82,是能从数学上算出来的起跑线,也是数据管道的核对基准。
-
训练循环五步骨架(清梯度 → 前向 → 反向传播 → 更新 → 定期评估)适用于一切 LLM 训练;AdamW 把权重衰减从梯度尺度中解耦,是 LLM 训练的正则首选。
-
5145 词元 × 124M 参数必然过拟合:train/val 分叉、逐字背诵原文、「每个词元被看 9 遍」都是实验的教学目的;大数据集上预训练通常只训一轮。
-
温度与 Top-k 两个解码参数分别控制分布形状与候选上限;−∞ 掩码与第 3 章因果注意力同源。
-
权重保存要连优化器状态一起考虑(622 MB 的 model.pth + checkpoint 设计);官方权重经 safetensors 解析、键名映射、Conv1D split + 转置、qkv_bias 切换与 weight tying 装入自研模型;assign 做形状校验,形状不匹配立即抛错。
自测清单
能不回看就答出这些,本章就算过关:
-
未训练模型 loss ≈ 11.0,与 ln(50257)≈10.82 量级对上(略高属正常; 数据管道无 bug 的证明)
-
9 个训练批次、train/val 切分 90/10;两 DataLoader 的 shuffle/drop_last 差异说得出理由
-
交叉熵手算六步说得顺:前向 → softmax → 取目标概率 → 取对数 → 均值 → 取负
-
10 轮训练后 train loss 进入 1 以下、val loss 明显反弹(过拟合现象直接确认)
-
生成的 "quite insensible to the irony" 能在 The Verdict 原文中找到 (记忆的直接证据)
-
T=0.1 时 P(forward)≈0.99,T=5 时 pizza 也有非零概率
-
能说出 AdamW 与 Adam 的差别是「解耦权重衰减」以及稀释问题出在哪
-
model.pth约 622 MB,加载后生成与原模型完全一致(yes) -
说得出为什么只存权重不够——优化器状态丢了会怎样
-
官方权重生成连贯英文,无乱码(键名映射 + 形状翻转全部正确)
习题
-
把
num_epochs改成 1 和 20 各跑一次,观察 val loss 的「先降后升」拐点在哪里。 -
把
top_k改成 1(退化为贪心)、temperature改成 0.5,对比生成文本的多样性。 -
把训练/验证比例改成 50/50,val loss 会怎样变化?为什么?
-
在
generate里传入eos_id(<|endoftext|>的 ID 是 50256),验证生成提前停止。 -
把
evaluate_model里的eval_iter加大到全部批次,观察评估值与eval_iter=5时的偏差——「用少量批次快速估算损失」的精度代价。 -
(思考)为什么加载官方权重时把
context_length改回 1024 的同时 必须改qkv_bias=true?两处不改分别会出什么事?
拓展阅读
-
Radford et al., 2019, Language Models are Unsupervised Multitask Learners(GPT-2 与其训练数据 OpenWebText): https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
-
Loshchilov & Hutter, 2019, Decoupled Weight Decay Regularization(AdamW 原始论文): https://arxiv.org/abs/1711.05101
-
safetensors 官方文档(8 字节 header + JSON 布局的规范): https://huggingface.co/docs/safetensors
-
GPT-2 官方模型卡(词表 50257 与权重下载): https://huggingface.co/openai-community/gpt2
-
Llama 2 7B 官方模型卡(预训练 184,320 GPU 小时出处): https://huggingface.co/meta-llama/Llama-2-7b-hf